İçindekiler13 başlık
Sohbet penceresinde cevap yalnız metinden oluşmak zorunda değil. Altına bir ürün kartı, bir rezervasyon kartı, "Tümünü gör" gibi bir çip ya da bir form eklenebilir. Bunlara sohbet içi bileşen diyoruz. Doğru anda çıkan bir kart misafirin işini kısaltır. Yanlış anda çıkan kart ise cevabı gölgeler ve "bana bir şey satılmaya çalışılıyor" hissi verir.
Dolphy'de ilk sürümlerde bileşenler neredeyse her cevapta çıkabiliyordu. Kullanıcı gözlemi netti: diğer asistanlarda kart bir şey tetiklenince çıkıyor, bizde her zaman. Bu yazı bileşen kararını nasıl ölçtüğümüzü ve vardığımız kuralı anlatıyor.
İlk bulgu: 20 madde ve marka kartları
Bir e-ticaret test sitesinde "Hangi markaları satıyorsunuz?" sorusuna asistan 20 maddelik bir liste yazdı ve altına iki "marka kartı" ekledi. Kartlardan biri mağazanın kendi adıydı. İlk değerlendirme koşusunda kurallı kontrolden geçemeyen 7 vakanın çoğu kart hatasıydı: marka kartları, kategori kartları, bir fiyat tablosunun "Ücretsiz" hücresinden üretilmiş kart, kampanya kartları.
İlk düzeltmeler bu tür hatalara yönelikti:
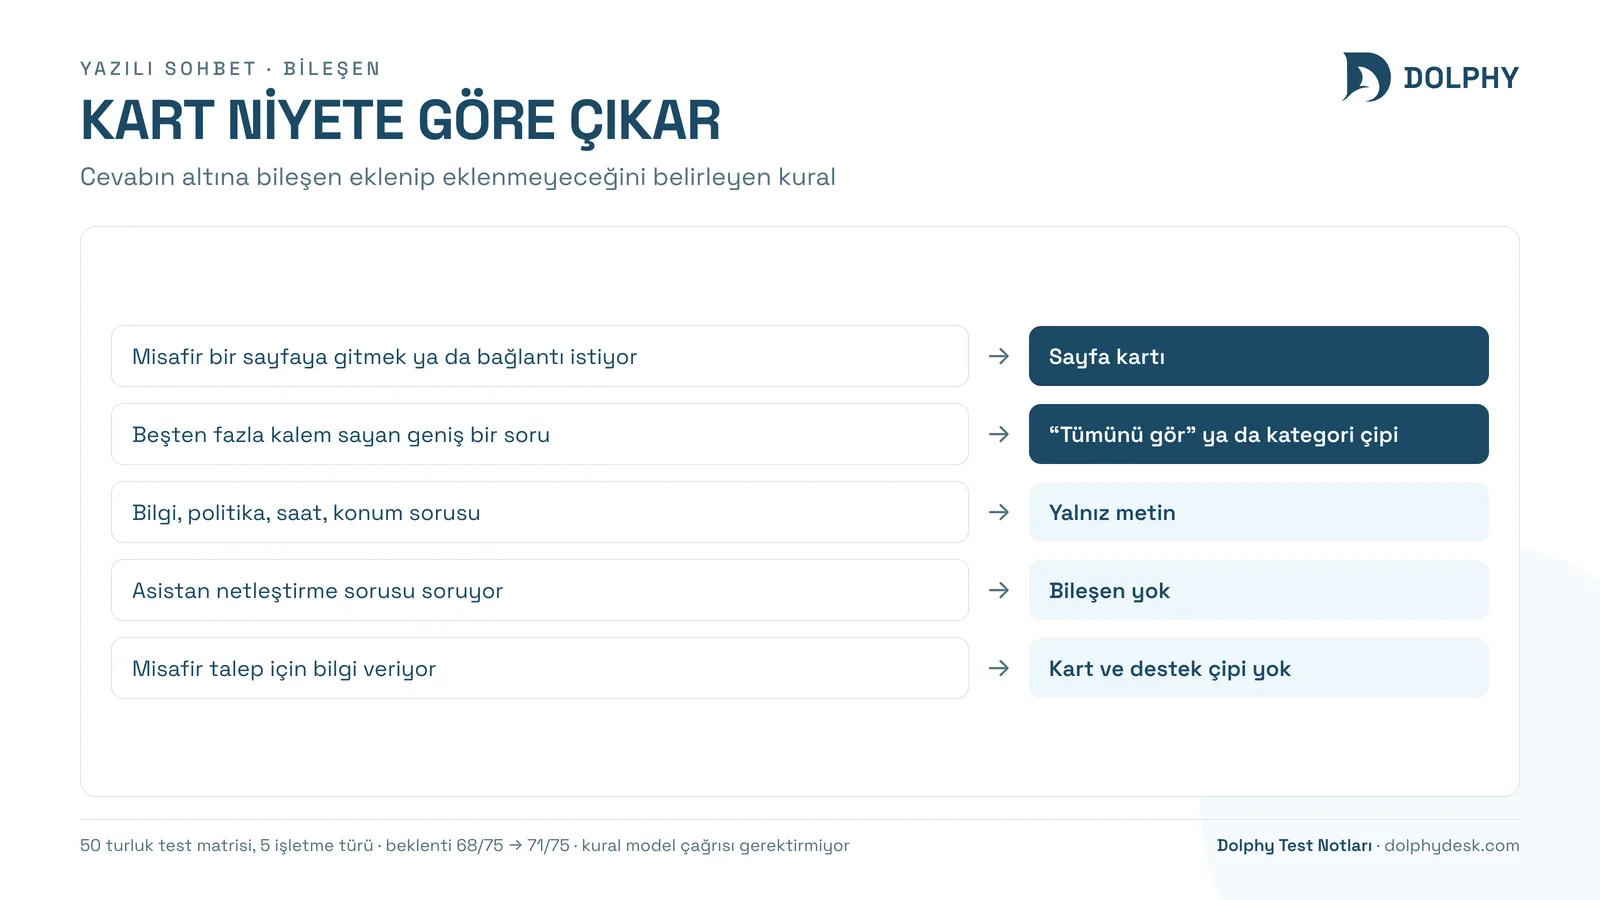
- Sayım kapısı: Cevap beşten fazla kalem sayıyorsa kart gösterilmiyor; onun yerine ilgili liste sayfasına "Tümünü gör" çipi çıkıyor. Ondalık virgül ("479,90") kalem ayracı sayılmıyor; ilk sürüm tek bir fiyatlı cevabı kartsız bırakmıştı.
- Kart olmayanlar: Marka ve kategori dizinleri, tablo hücreleri ve kurumsal sayfalar kart üretmiyor.
- Kardeş ürün: Cevap bir ürünü tam adıyla andıysa, adı aynı kelimelerle başlayan kardeş ürünün kartı basılmıyor.
Bu kurallardan sonra kart hatası 7'den 0'a indi. Ama sorun kalem eşleştirmeden büyüktü: kartın çıkıp çıkmayacağına yalnız cevap metnine bakarak karar veriyorduk.
Rakipler bileşen kararını nasıl veriyor?
Belgelerini ve kamuya açık anlatımlarını inceledik:
| Kaynak | Bileşen kararı |
|---|---|
| Amazon Rufus | Önce sorguyu sınıflıyor (bilgi mi, işlem mi); kartlar sonra doluyor |
| ChatGPT ve Perplexity alışveriş | Ürün kartı yalnız satın alma niyeti sezilince, 3-5 kart |
| Google konuşma tasarımı | "Görsel her turda gerekmez"; yalnız seçim, karşılaştırma ya da netleştirme katıyorsa |
| Google RCS, Meta Messenger | Çip yalnız son mesajla ilgili ve gerektiği kadar |
| Intercom Fin | Emin değilse netleştirme sorar, yapılandırılmış öğe göstermez |
| Gorgias | İade ve kargo sorusunda ürün önerisini kapattı |
| Zendesk | Karusel en fazla 10 kart |
| Baymard, Nielsen Norman | İstenmeden çıkan öğe "itici satış" algısı yaratıyor |
Ortak desen açıktı: bileşen niyete bağlı. Bizde ise kart kararı yalnız cevabın adlandırdığı kaleme, rezervasyon kartı da niyet sözcüğüne bakıyordu.
50 turluk test matrisi
Beş farklı işletme türünde (otel, e-ticaret, klinik, işlem yapabilen bir e-ticaret, bir yazılım şirketi) 13 konuşmadan oluşan 50 turluk bir test hazırladık. Her tur gerçek cevap hattından geçiyor ve her bileşen için beklenti yazılı: çıkmalı, çıkmamalı ya da fark etmez. Niyet sınıfları: seçim, karşılaştırma, bilgi/politika, netleştirme, talep, kapanış, kapsam dışı, devir.
Başlangıç bulguları:
| Tur | Sorun |
|---|---|
| Otel: "Kahvaltı fiyata dahil mi?" | Altına rezervasyon kartı çıktı |
| Otel: "Rezervasyonu iptal edersem ücret kesiliyor mu?" | Altına rezervasyon kartı çıktı |
| Klinik: "Dişim ağrıyor, ne yapmalıyım?" | Devir sayıldı, bot duraklatıldı, sonraki iki tur boş cevap |
| Yazılım: "Paketleriniz ve fiyatlarınız neler?" | 3 paket kartı yerine "Tümünü gör" çıktı |
| Otel ve klinik | Kartta ve metinde aynı adres tekrarlandı |
Bilgi turlarında (saat, konum, iade, garanti, kargo) ürün kartı hiç görülmedi; eşleştirme kapıları bunları zaten eliyordu. Sorunlar rezervasyon kartında, devir kararında ve sayım kapısındaydı. "Paketler" vakasında madde içindeki virgüller kalem sayılmıştı.
Niyet tabanlı politika
Model çağrısı gerektirmeyen bir politika katmanı eklendi. Tur sonunda, mevcut eşleştirme kapılarının üstünde çalışıyor:
- Selamlama, kapanış, devir, çalışma saati, konum ve seçenek sorularında bilgi tabanı kartı ve rezervasyon kartı yok.
- Yalnız soru soran bir cevapta (asistan netleştirme istiyorsa) hiçbir bileşen yok.
- Misafir iletişim bilgisi yazarken rezervasyon kartı yok.
- Koşul, iptal, iade ve "dahil mi" soruları bilgi niyeti sayılıyor; içinde "fiyat" ya da "rezervasyon" sözcüğü geçse bile.
- Modelin "insana devret" kararı, misafir bir insanı anmıyorsa geçersiz. "Dişim ağrıyor" bir devir isteği değil.
Her kararın gerekçesi kayda yazılıyor. Modelin her turda hangi bileşeni göstereceğine karar verdiği bir araç ("show_items") da değerlendirildi ve reddedildi: katı şema her turda prompta biniyordu, sesli kanalda araç yoktu ve ölçülmüş bir boşluğu kapatmıyordu.
| Koşu | Tutan beklenti | Kart ve metinde aynı adres |
|---|---|---|
| Başlangıç | 68/75 | 1 |
| Politika sonrası | 71/75 | 3 |
| Adres notu ve netleştirme tanımı | 70/75 | 0 |
Son koşuda kalan "hatalar" beklenti hatasıydı: bir kart önceki turda zaten gösterildiyse ikinci turda gösterilmemesi kilitli bir tekrar kuralıydı. Toplam harcama, test sitelerinin taranması dahil yaklaşık 0,24 dolar oldu.
Daha sade kural: kart yalnız yönlendirmede
Politika hataları kapattı ama kullanım gözlemi bir adım daha ileri götürdü: "İncele" ve "Seç" kartları hâlâ çok sık çıkıyordu. Bir başka gözlemde misafir adını yazdıktan sonra her turda bir "Ekiple konuş" çipi belirdi. Ad, telefon ve onay turlarında bilgi tabanı araması doğal olarak zayıf dönüyordu ve düşük güven sinyali destek çipini tetikliyordu.
Kural sadeleşti:
- Otomatik ürün kartları kapandı. Kart yalnız misafiri bir sayfaya yönlendirirken çıkıyor: model bunun için ayrı bir araç çağırıyor ("sayfayı göster").
- Metinde bağlantı kalırsa kart kurallı olarak oluşuyor. Misafir "bu bilgi hangi kaynakta?" diye sorduğunda cevap düz metin bağlantı değil, tıklanabilir bir sayfa kartı.
- Talep akışında çip yok. Botun sorusuna verilen cevapta ve talep toplanırken destek çipi gösterilmiyor.
- Kartlar görselsiz ve tek tasarımlı. Her işletmede aynı.
Gerçek turlarda davranış beklendiği gibi oldu: mağazada fiyat sorusunda kart yok, "nereden satın alabilirim?" sorusunda ürün kartı var; otelde oda listesinde kart yok; "linkini atar mısın?" sorusunda hizmet sayfası kartı var. Hakemli setlerde tam geçen vaka sayısı değişmedi, kart sayısı neredeyse sıfıra indi.
Geniş listelerde karta alternatif olarak kategori çipleri kullanılıyor: asistan üç ya da daha fazla kalem sayan bir sunum cevabı verdiyse altında en kalabalık dört kategori çip olarak çıkıyor ("Genel Diş Tedavisi", "İmplant ve Protez" gibi).
Model değişince bileşen davranışı da değişiyor
Bu kuralın model bağımlılığı sonradan ortaya çıktı. Daha yeni bir modeli aynı hakemli sette denediğimizde, sayfa gösterme aracını çok daha sık çağırdı: bir klinik setinde 24 turun 11'inde kart çıktı, mevcut modelde 0. Her araç çağrısı ikinci bir model adımı demek; tur süresi medyanı 3,0 saniyeden yaklaşık 4,1 saniyeye çıktı. Model değişikliği bir bileşen testi olmadan yapılmamalı (model seçimi yazısı).
Kendi asistanınızda nasıl uygularsınız?
- Bileşeni niyete bağlayın. Metinde bir ürün adı geçiyor diye kart göstermeyin; misafirin niyeti seçmek ya da gitmek mi, ona bakın.
- Netleştirme sorusunda bileşen göstermeyin. Asistan soru soruyorsa misafirin cevabını beklemeli.
- Bilgi ve politika sorularında satış bileşenini kapatın. "İptal edersem ücret kesilir mi?" sorusunun altındaki rezervasyon kartı yardım değil baskıdır.
- Beklentili bir test matrisi yazın. Her tur için "çıkmalı / çıkmamalı / fark etmez" yazmak, bileşen hatalarını ölçülebilir yapar.
- Model değişikliğinde bileşen testini yeniden koşun. Araç çağırma eğilimi modelden modele değişir.
Ölçümün sınırları
Matris 50 tur ve beş test sitesinden oluşuyor; her sektörün her niyetini kapsamaz. Koşular yerel bir veri kopyasında yapıldı. Kullanıcı tercihi ölçümü (kartın ne sıklıkla tıklandığı) bu çalışmanın parçası değildi.
Sık sorulan sorular
Bu bölümdeki sorular, aynı konuda en sık arananlardan derlendi.
01Chatbot her cevabın altına ürün kartı göstermeli mi?
Hayır. İncelediğimiz sistemlerin ortak deseni kartı satın alma ya da seçim niyetine bağlamak. Bilgi, politika ve netleştirme turlarında kart göstermek cevabı gölgeleyebilir ve itici bir satış hissi yaratabilir.
02Uzun listelerde kart mı, çip mi?
Bizim kuralımızda cevap beşten fazla kalem sayıyorsa kart gösterilmiyor; ilgili liste sayfasına bir "Tümünü gör" çipi ya da en kalabalık kategoriler çip olarak çıkıyor. Zendesk gibi sistemler karuseli 10 kartla sınırlıyor.
03Bileşen kararını modele mi bırakmalı, kurala mı?
İkisi birlikte. Sayfaya yönlendirme gibi niyetleri model bir araçla belirtiyor; hangi niyette hangi bileşenin asla çıkmayacağını ise model çağrısı gerektirmeyen bir kural katmanı belirliyor. Yalnız modele bırakmak, model değiştiğinde davranışın da değişmesine yol açtı.
04Sohbet içi bileşenler nasıl test edilir?
Her tur için beklenti yazılan bir test matrisiyle: bu turda kart çıkmalı mı, çıkmamalı mı, fark etmez mi? Gerçek cevap hattından geçen 50 turluk bir matris, bizde bilgi turlarındaki rezervasyon kartını, yanlış devri ve sayım hatasını yakaladı.
Mustafa Gürbüz
Dolphy Yöneticisi
Dolphy'nin yöneticisi. Sesli asistan, yazılı sohbet ve bilgi tabanı hattındaki testleri yürütüyor. Yazılardaki sayılar Dolphy'nin kendi test ortamında alınan ölçümlerden geliyor; her yazı ölçümün kapsamını ve sınırını da söylüyor.
İçerik 28 Eylül 2026 tarihinde kontrol edildi
Aynı soruları müşterilere tekrar tekrar yazmayın
Dolphy web sitesi, WhatsApp ve Instagram'da işletmenizin kendi bilgisiyle yanıt verir, talepleri panele düşürür.