İçindekiler12 başlık
Bilgi tabanından cevap üreten bir chatbotu (RAG) test ederken ilk bakılan ölçü genellikle recall'dur: doğru sayfa ilk birkaç sonuç içinde geliyor mu? Bizim test setlerimizde bu oran %93 ile %100 arasındaydı. Yine de bot bazı sorularda eksik ya da yanlış ayrıntılı cevap veriyordu.
Recall, sorunun bulunamadığını göstermiyordu. Sorun bulunan sayfanın modele nasıl ulaştığındaydı. Bu yazıda recall'un göremediği dört katmanı ve her birini nasıl ölçtüğümüzü anlatıyoruz. Ölçümler farklı sektörlerden test sitelerinde yapıldı: bir otel, bir e-ticaret mağazası, bir klinik, bir emlak sitesi ve Dolphy'nin kendi sitesi.
1. Doğru sayfa bulunuyor, içeriğin çoğu modele gitmiyor
Bilgi tabanı 4.885 parçadan oluşuyordu. Parça boyu medyanı 143 token'dı; parçalama penceresi ise 700 token. Parçaların %67'si 200 token'ın altındaydı. Tek bir blog sayfası 21, tek bir ürün sayfası 18 parçaya bölünmüştü.
Arama her sayfadan en fazla 3-4 parça alıyor. Hesap basit: 3.000 token'lık bir sayfadan modele giden metin 3 × 143 ≈ 430 token, yani sayfanın yedide biri. Doğru sayfa listede, ama içeriğinin çoğu promptun dışında.
Sebep parçalayıcının bir kuralıydı: her H1/H2 başlığı koşulsuz yeni parça açıyordu. Yapay zekâ ile düzenlenen sayfalar çok sayıda ## başlığı içerdiği için parçalar ufalanıyordu. Kurala bir alt sınır eklendi: 250 token'dan kısa bölüm yeni parça açmıyor, bir öncekiyle birleşiyor.
| Ölçü | Önce | Sonra |
|---|---|---|
| Toplam parça | 4.885 | 2.473 |
| Parça boyu p10 | 63 | 206 |
| Parça boyu p50 | 143 | 362 |
| Parça boyu p90 | 416 | 657 |
| 200 token altı parça | %67 | %9 |
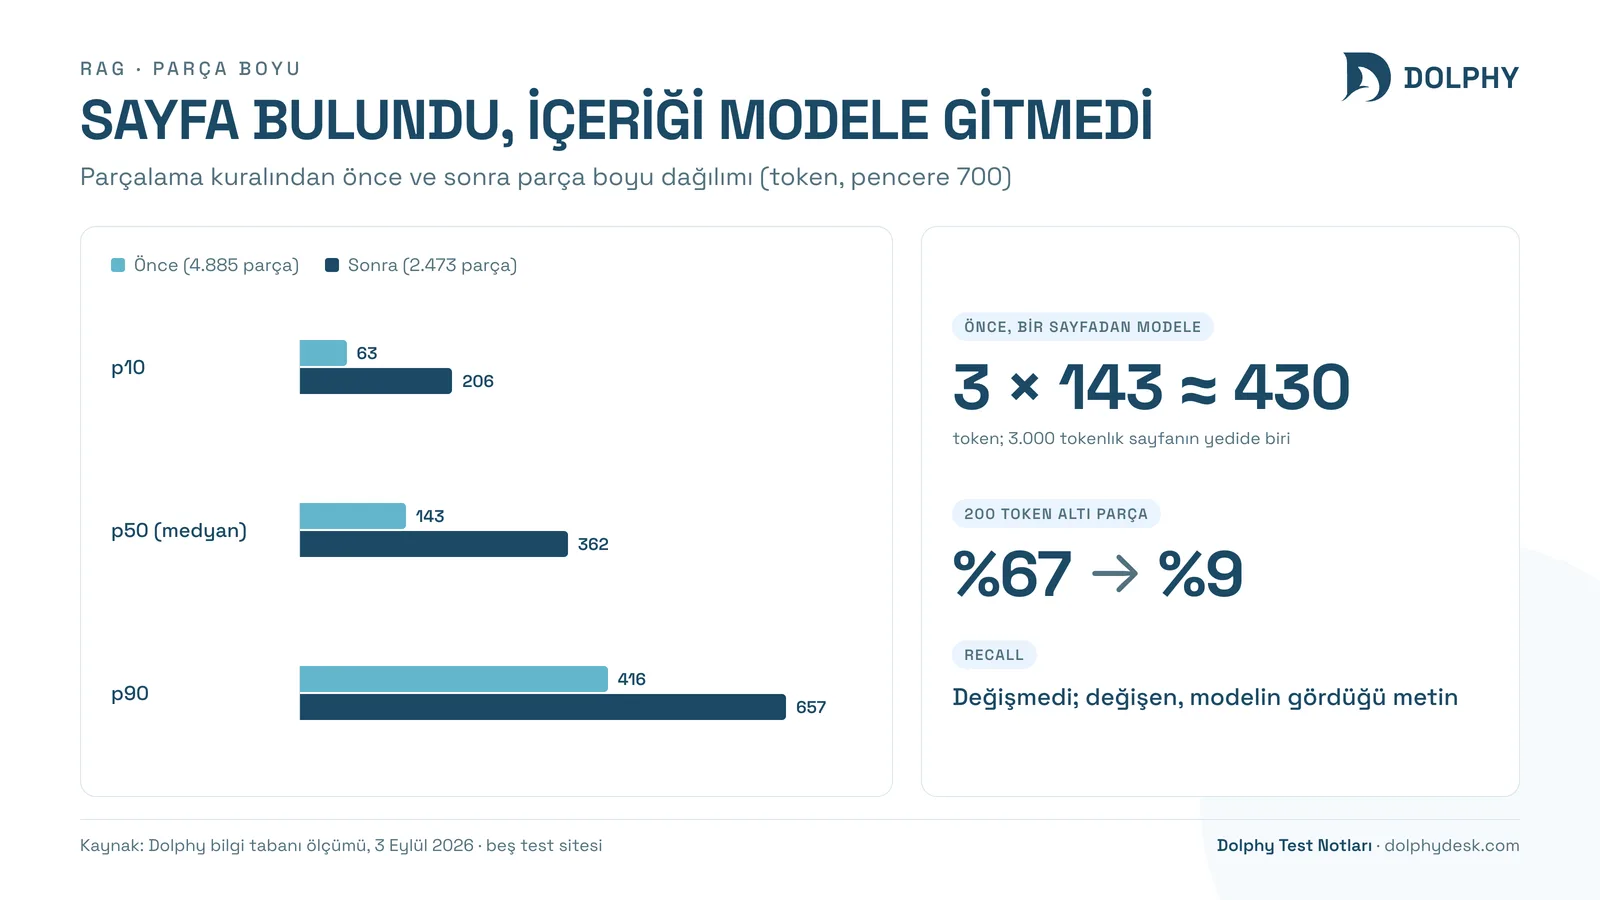
Recall değişmedi; değişmesi de beklenmiyordu. Değişen, modelin doğru sayfadan gördüğü metin miktarıydı. Bu yüzden ölçümü sayfa isabetinden olgu kapsamasına genişlettik: sorunun cevabı için gereken bütün bilgiler ilk 8 parçada mı?
Bu ölçümde bir tuzak da vardı. MRR (doğru parçanın sırası) parça boyları arasında karşılaştırılabilir bir ölçü değil. Aynı sayfa 3 parça yerine 1 parça üretince, aranan metnin ilk sıraya düşme olasılığı yalnız sayı yüzünden değişiyor.
2. Ürün kartlarının yarısı kopyaydı
Sohbette ürün sorulduğunda cevabın altında bir kart gösteriliyor: görsel, fiyat, bağlantı. Kartlar sayfa taranırken çıkarılıyor. Bir e-ticaret test sitesinde 686 kart satırı vardı ama yalnız 303 farklı başlık: kartların %55,8'i kopyaydı. Aynı ürün kendi sayfasında, kategori listesinde ve marka listesinde ayrı ayrı geçiyor, her sayfa kendi kartını yazıyordu.
Kopyalar birbirinin aynısı değildi:
| Kart nereden geliyor? | Kart | Görselli |
|---|---|---|
| Ürün sayfası | 199 | %97,5 |
| Liste sayfası (kategori, marka) | 487 | %1,6 |
179 kopya kümesinin 131'inde fiyat kopyalar arasında çelişiyordu. Liste sayfası görünür metinden en ucuz varyantın fiyatını alıyordu; ürün sayfası yapılandırılmış veriden paket boyutuyla birlikte doğru fiyatı. Bir kedi maması örneğinde liste kartı 1.559,90 ₺ yazıyordu (hangi paket olduğunu söylemeden), ürün sayfası kartı 15 kg paket için 7.769,90 ₺.
Kartları seçen sorgu sırasız ve 8 satırla sınırlıydı. Tablonun yarısı kopya olduğu için zengin kopya çoğu zaman o sekize hiç girmiyordu. Sonuç: bot doğru ürünü söylüyor, altındaki kart görselsiz, yanlış fiyatlı ve kategori sayfasına gidiyordu. Retrieval hatası değildi; beş test setindeki 114 sorgunun hepsinde doğru sayfa ilk 8'deydi.
Düzeltme kart katmanında yapıldı: kopyalar birleştirilirken boş alan diğer kopyadan dolduruluyor, bağlantı görseli taşıyan kopyadan (pratikte ürünün kendi sayfası) alınıyor, fiyat biçimi tekleşiyor ve seçim sırası belirli.
3. Sözcüksel arama pratikte çalışmıyordu
Hibrit arama iki koldan oluşuyor: anlam benzerliği (vektör) ve kelime eşleşmesi (sözcüksel). Ürün kodları, model adları ve özel terimler için sözcüksel kol önemli; vektörler "PT100" ile "SHT31" arasındaki farkı iyi ayırmaz.
Ölçünce sözcüksel kolun gerçekçi sorularda neredeyse hiç sonuç döndürmediğini gördük. Kullanılan PostgreSQL fonksiyonu sorudaki bütün kelimeleri "VE" ile bağlıyordu. "Kısırlaştırılmış kediler için hangi mamayı önerirsiniz" gibi doğal bir soruda bütün kelimelerin aynı parçada geçmesi gerekiyordu. Bir test sitesinde 10 gerçekçi sorunun 10'unda sıfır eşleşme vardı; diğerlerinde 10'da 8 ve 10'da 2.
Bu kolu açmayı daha önce denemiş ve MRR'ı düşürdüğü için kapatmıştık. Kayda bakınca o ölçümün rerank açıkken alındığı ortaya çıktı; rerank sonradan kaldırılmıştı (rerank yazısı). Ölçüm geçersizdi.
Sözcüksel kol için ürün koduyla arayan ayrı bir test seti yazdık (PT100, SHT31, NRF24L01, RP2040 gibi) ve kelimeleri "VEYA" ile bağlayan ikinci bir kolu altı sette ölçtük:
| Set | Kapalı (MRR) | Açık (MRR) |
|---|---|---|
| E-ticaret (evcil hayvan) | 0,861 | 0,890 |
| E-ticaret (elektronik) | 0,931 | 0,928 |
| Otel | 0,719 | 0,822 |
| Emlak | 0,870 | 0,912 |
| Emlak (İngilizce) | 0,847 | 0,975 |
| Ürün kodu | 0,900 (hit %93) | 0,922 (hit %100) |
Hiçbir sette ilk 8 isabeti düşmedi. Kol varsayılan olarak açıldı. "VEYA" tek başına havuzu şişirdiği için (bir soruda 1.475 parçanın 1.302'si eşleşiyordu) sıralamayı vektör kolu ve füzyon belirliyor.
Aynı katmanda bir dil varsayımı da vardı. Tam metin arama Türkçe kök bulucuya (turkish) kilitliydi. Türkçe kök bulucu İngilizce kelimeyi tanımıyor; İngilizce içerikte sözcüksel kol sessizce kayboluyordu. Kök bulmayan ikinci bir kolon (simple) eklendi ve iki kolun sonucu birleştiriliyor. Hata vermeyen, yalnız daha az bulan bir sorundu.
4. Blog yazısı hizmet sayfasının önüne geçiyor
Bir klinik test sitesinde "çene botoksu yapıyor musunuz?" sorusuna bot "sunulup sunulmadığını kesinleştiremiyorum" dedi. Hizmet sayfası vardı; ama arama sonuçlarında aynı konudaki blog yazılarının arkasında, 5.-6. sıradaydı. 20 vakalık bir sıralama setinde ilk 8 isabeti %95, ilk sıra isabeti %74'tü. İlk sırayı kaçıran beş vakanın dördünde öne geçen bir blog yazısıydı.
Önce sorunun gerçekten aramada olup olmadığını ayırdık. Sekiz niyeti beş farklı biçimde yazdık (düz soru, yazım hatalı günlük dil, dolaylı ihtiyaç, istek kipi, İngilizce) ve 40 gerçek turda üç katmanı ayrı ölçtük:
- Anlama: Niyet doğru mu sınıflandırıldı? 40/40.
- Bulma: Beklenen sayfa kaçıncı sırada?
- Cevap: Cevap doğru mu, kaçamak mı? 37/40.
Hataların kaynağı bulmaydı. İlk deneme yazı sayfalarına her soruda ceza vermekti: hizmet soruları düzeldi, fiyat ve blog soruları geriledi. Cezayı yalnız hizmet niyetinde uygulamak test laboratuvarında kusursuz göründü (hizmet sorularında MRR 0,65 → 1,00). Gerçek turda ise işletmenin kendi ürününü anlatan blog yazısını da geri itti ve iki vakada kanıt kayboldu. Geri alındı.
Kalan çözüm sıralamaya dokunmuyor: niyet hizmet, randevu ya da müsaitlikse ve en iyi hizmet sayfası seçilen parçalarda yoksa, yeterince yüksek skorlu hizmet sayfası en zayıf blog parçalarının yerine giriyor. Sayfa türü taramada belirleniyor (yapılandırılmış verideki BlogPosting türü ya da WordPress'in single-post sınıfı). Beş test sitesinde kural her soruya uygulansa bile hiçbir sıralama değişmedi, yani başka soruları bozmuyor. Aynı soru beş ardışık gerçek turda 0/5'ten 5/5'e çıktı.
Bağlam bütçesi
Son bir deneme modele giden bilgi miktarıyla ilgiliydi. Bilgi bütçesi 4.000 token ve 8 geçmiş mesajdan 6.000 token ve 12 mesaja çıkarıldı. Altı hakemli sette tam geçen vaka 86'dan 90'a, kurallı kontrollerden geçen vaka 93'ten 96'ya çıktı. Giriş token'ı yalnız %0,5 arttı, çünkü bütçe bu setlerde nadiren doluyordu. Sesli kanalda bütçe gecikme yüzünden 1.600 token'da kaldı.
Geniş sorular için bir de katalog özeti ekledik. "Hangi tedavileri yapıyorsunuz?" gibi bir soruda model o turun sekiz parçasını görüyor ve 85 kalemli bir klinikte yalnız üç kalemi anıyordu. Bilgi bloğunun başına kategori ve örnek adlardan oluşan bir özet giriyor. Bu özet 7-8 kalemli sitelerde fiyat ve saat ayrıntısını azalttığı için yalnız 12'den fazla ayrı kalem olan sitelerde ekleniyor. Özetin içine toplam sayı yazılmıyor; neredeyse aynı adlar sayımı şişirdi ve model bir denemede "toplam 82 kalem" dedi.
RAG testinizi nasıl kurarsınız?
- Recall'u tek ölçü yapmayın. Doğru sayfa bulunsa da cevap için gereken bilgi modele ulaşmayabilir. Olgu kapsamasını ölçün.
- Parça boyu dağılımına bakın. Medyan parça pencerenin küçük bir kesriyse içerik ufalanıyor demektir.
- Retrieval sonrası katmanları ayrı test edin. Kart, fiyat, bağlantı gibi çıktılar retrieval'dan bağımsız bozulabilir.
- Her kolu ayrı ölçün. Hibrit aramanın sözcüksel kolu sessizce çalışmıyor olabilir; ürün kodu gibi ona özgü bir test seti yazın.
- Eski ölçümün koşullarını kontrol edin. Kapatılmış bir özelliğin gerekçesi, sonradan değişen bir koşula dayanıyor olabilir.
- Laboratuvar sonucunu gerçek turla doğrulayın. Sıralama laboratuvarında kusursuz görünen bir ceza, gerçek cevapta kanıt kaybettirdi.
Ölçümün sınırları
Test setleri 15-35 vakalık; bu boyutta ±1 vaka ve ±0,03 MRR fark gürültü düzeyinde (hakem ve gürültü yazısı). Siteler test amaçlı taranmış gerçek sitelerdi ama her sektörü temsil etmez. Olgu kapsaması etiketleri birkaç set için elle yazıldı.
Sık sorulan sorular
Bu bölümdeki sorular, aynı konuda en sık arananlardan derlendi.
01RAG'de recall yüksekken cevap neden yanlış olur?
Çünkü recall yalnız doğru sayfanın listede olup olmadığını ölçer. Sayfanın içeriği küçük parçalara bölündüyse gereken bilgi modele gitmeyebilir; retrieval'dan sonra çalışan kart, fiyat ve bağlantı katmanları da ayrıca bozulabilir. Olgu kapsaması ve cevap doğruluğu ayrı ölçülmeli.
02RAG için ideal parça boyu nedir?
Tek bir doğru değer yok. Bizim hattımızda 700 token'lık pencerede medyan parça 143 token'dan 362 token'a çıkınca model aynı sayfadan çok daha fazla bilgi görmeye başladı ve recall değişmedi. Parça boyunu ayarlamadan önce mevcut dağılımı ölçmenizi öneririz.
03Hibrit aramada sözcüksel kol gerekli mi?
Ürün kodu, model adı ve özel terimler için evet. Ama doğal dildeki sorularda bütün kelimeleri "VE" ile bağlayan bir sorgu neredeyse hiç sonuç döndürmeyebilir. Bizim ölçümümüzde "VEYA" ile bağlanan bir kol hiçbir sette isabeti düşürmedi ve bazı setlerde MRR'ı belirgin artırdı.
04Blog yazıları hizmet sayfasını neden geçiyor?
Blog yazıları konuyu uzun ve ayrıntılı anlattığı için anlam benzerliğinde öne çıkabilir. Genel bir ceza başka soruları bozdu; bizde işe yarayan, sıralamayı değiştirmeden hizmet sayfasının sonuçlarda bulunmasını garanti eden dar bir kural oldu.
Mustafa Gürbüz
Dolphy Yöneticisi
Dolphy'nin yöneticisi. Sesli asistan, yazılı sohbet ve bilgi tabanı hattındaki testleri yürütüyor. Yazılardaki sayılar Dolphy'nin kendi test ortamında alınan ölçümlerden geliyor; her yazı ölçümün kapsamını ve sınırını da söylüyor.
İçerik 28 Eylül 2026 tarihinde kontrol edildi
Aynı soruları müşterilere tekrar tekrar yazmayın
Dolphy web sitesi, WhatsApp ve Instagram'da işletmenizin kendi bilgisiyle yanıt verir, talepleri panele düşürür.