İçindekiler14 başlık
Bir müşteri asistanının en tehlikeli hatası "bilmiyorum" demek değil, bilmediği bir şeyi bildiğini söylemektir. 2024'te Kanada'da bir havayolu şirketi, sohbet botunun uydurduğu bir iade politikasıyla mahkemede bağlandı. Mahkeme "bot ayrı bir varlık" savunmasını kabul etmedi.
Dolphy'de asistanın kuralı basit: bilgi tabanında olmayanı söyleme. Kuralın tutup tutmadığını ise ölçmek gerekiyor. Bu yazı, o ölçümü kurarken öğrendiklerimizi anlatıyor. En önemlisi şu: ölçen araç da yanılıyor.
Araç nasıl çalışıyor?
Değerlendirme aracı, canlıdaki cevap hattını olduğu gibi çağırıyor. Arada bir kopya ya da taklit yok. Her test vakasında bir soru, isteğe bağlı bir konuşma geçmişi ve beklentiler var. Cevap iki katmandan geçiyor:
- Kurallı kontroller: Cevapta olması gereken ya da olmaması gereken ifadeler, kart sayısı, devir yapılıp yapılmadığı, cevap uzunluğu. Ucuz, tekrarlanabilir, rastgelelik içermiyor.
- Hakem model: Cevabı, modelin o turda gördüğü kanıtla birlikte okuyup beş soruya evet/hayır diyor: soruyu cevapladı mı, kanıta dayanıyor mu, kısa mı, doğru dilde mi, kart doğru mu? Hayırsa hata türünü de seçiyor.
Tasarımda bazı kararları literatürden aldık:
- İkili puan, ölçek değil. "1-5 arası puanla" yerine geçti/kaldı. Uygulayıcıların ortak önerisi: ikili karar daha tutarlı ve daha kolay doğrulanıyor.
- Hakem başka aileden. Bir model kendi çıktısını yargılarken kendi lehine eğilim gösterebiliyor (öz-tercih yanlılığı). Cevap modeli OpenAI'den, hakem Google'dan.
- Harcama tavanı. Her koşu gerçek token kullanımını sayıyor ve belirlenen tavanı aşınca duruyor. 30 vakalık hakemli bir koşu yaklaşık 0,12 dolar.
- Çok turlu vakalar. Çok turlu RAG üzerine yapılan bir çalışma, hataların en çok takip sorularında ve cevabı olmayan sorularda çıktığını gösteriyor. Setlere ikisini de ekledik.
İlk ölçüm ve düzeltmeler
Bir e-ticaret test sitesinde 30 vakalık setle başladık. Kod değiştikçe aynı set yeniden koşuldu:
| Koşu | Kurallı kontrol | Hakemden tam geçen |
|---|---|---|
| Başlangıç | 23/30 | 14/17* |
| Kart ve devir düzeltmeleri | 30/30 | 22/30 |
| Ad eşleştirme | 27/30 | 22/30 |
| Sıralı tam eşleşme | 28/30 | 23/30 |
| Kardeş ürün kuralı | 29/30 | 26/30 |
* Başlangıçta hakem 13 vakada çıktı üretemedi; düşünme bütçesi yetmemişti. Hakemin kendisi de yapılandırılması gereken bir parça.
Hakem, kurallı kontrollerin göremeyeceği hatalar yakaladı. Model bilgi tabanında olmayan somut ayrıntılar ekliyordu: bir havalimanına "50 km" uzaklık, "iade 20 iş günü" süresi, olmayan bir destek e-posta adresi. Başka bir test sitesinde bir sensör için ölçüm aralığı ve kablo uzunluğu uydurdu; bir ürünün 10'lu paket olduğunu atlayıp "1 adet" dedi.
Hakem de yanılıyor
Birkaç hafta ve birçok düzeltme sonra beş farklı işletme sitesinde 73 vakayla yeniden ölçtük: 65'i geçti, 8'i kaldı. "Kaldı" diyen 8 kararı tek tek okuduk:
| Karar | Vaka |
|---|---|
| Gerçek uydurma | 1 |
| Gerçek hata (aynı ürüne iki kart) | 1 |
| Hakemin yanlış negatifi | 3 |
| Doğru davranış, beklenti yanlış | 2 |
| Tartışmalı | 1 |
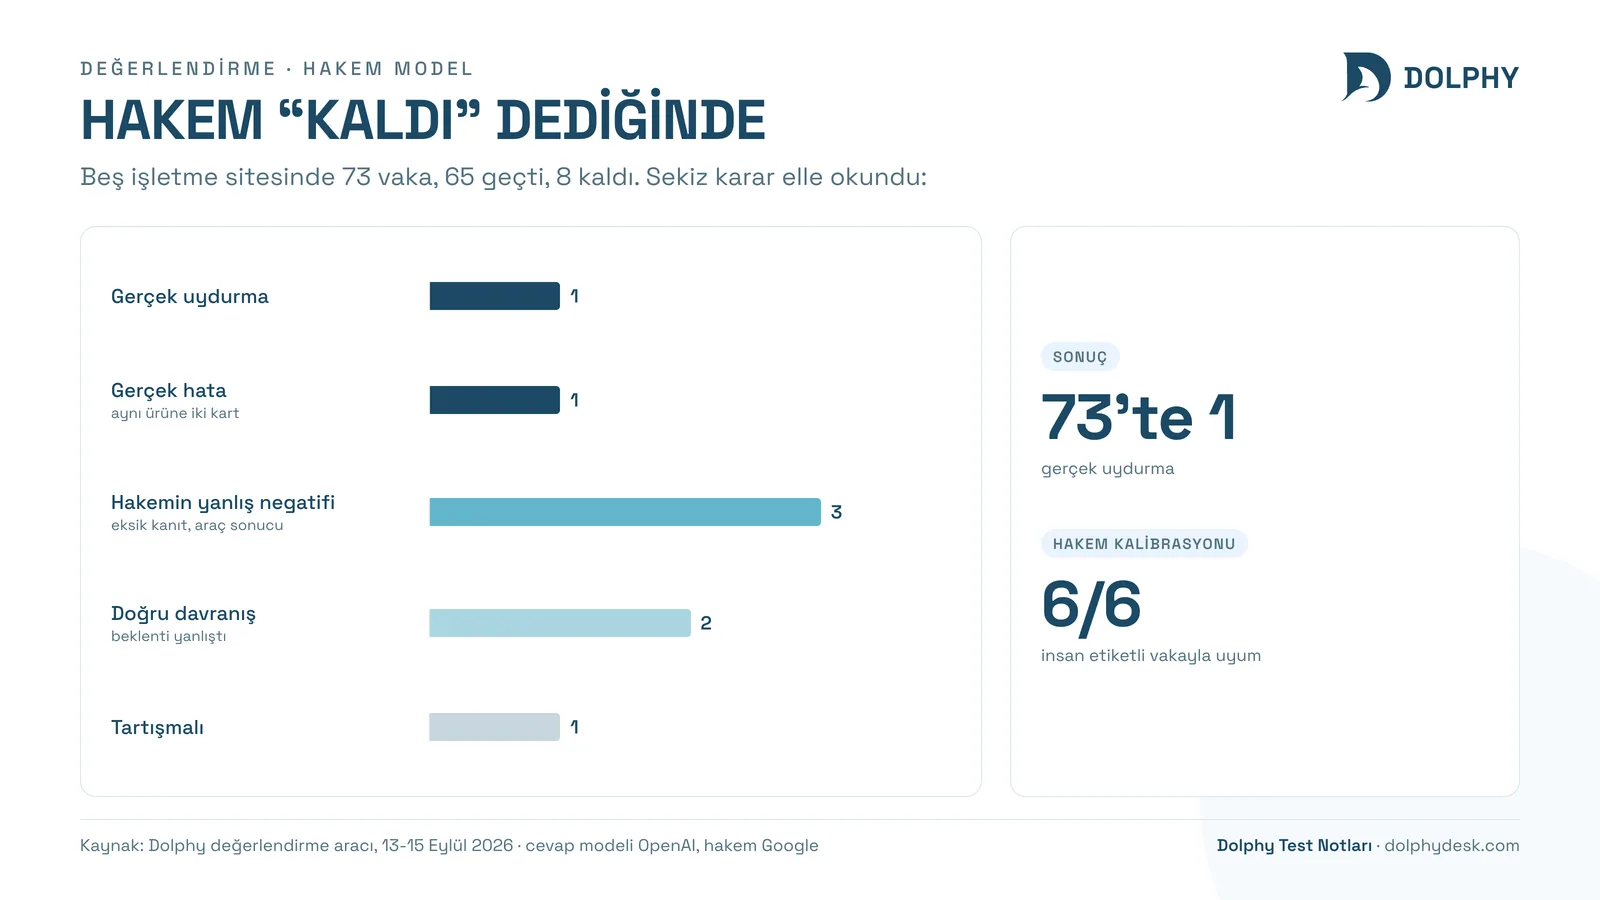
Hakemin yanlış negatiflerinin sebepleri öğreticiydi. Bir vakada stok bilgisi bilgi tabanından değil, stok sorgulayan bir işlem aracından gelmişti; hakem araç sonucunu görmediği için "kanıtsız" dedi. İki vakada telefon numarası bilgi tabanındaydı ama hakeme gösterilen beş alıntının içinde değildi.
Sonraki bir incelemede daha fazlası çıktı:
- Hakem en fazla 5 alıntı görüyor ve her birini 700 karakterde kesiyordu. Model ise 8 parça görüyordu.
- Kanıt, cevap üretildikten sonra değişebilen tablodan yeniden okunuyordu.
- Geçmişte yalnız misafirin mesajları vardı, asistanın önceki cevapları yoktu.
- Bir klinik vakasında cevap "850 TL" diyordu; hakem "85e TL yazılmış" diye reddetti.
- Hakeme turun tarihi verilmediği için "yarın" ifadesinin doğru çözümünü "kanıtta yok" saydı.
- Hakem, modelin gördüğü sayfa kalemi etiketlerini görmüyordu; doğru bir hizmet adını uydurma saydı.
Bunlar tek tek düzeltildi. Hakem artık modelin o turda gördüğü bilgi bloğunun aynısını görüyor.
Sonuç: 73 vakada 1 gerçek uydurma. Bir hafta önce görülen uydurmalar bu içerik ve kurallarla tekrar etmedi. Ama bu sonuca ancak hakemin kararlarını okuyarak varılabildi; hakemin ham puanı 65/73 diyordu.
Kalibrasyon ve sonuç sözleşmesi
İki değişiklik aracı güvenilir yaptı.
İnsan etiketli kalibrasyon. Küçük bir vaka setini elle "geçti" ya da "kaldı" diye etiketledik; "850/85e" gibi hakemin daha önce yanıldığı örnekler de içinde. Her hakem değişikliğinden sonra önce bu set koşuluyor. İlk kalibrasyon 6 vakada 6 uyum verdi ve 0,013 dolar tuttu.
Geçti / kaldı / hata. Araç önce yalnız harcama tavanı aşıldığında başarısız dönüyordu. Hakem bir vakada hata verirse o vaka sessizce paydadan çıkıyordu. Yanlış yazılmış bir vaka filtresi sıfır vaka koşup yeşil sonuç verebiliyordu. Artık her vaka geçti, kaldı ya da hata; hakem kapsaması ayrı raporlanıyor ve sıfır vakalı koşu başarı sayılmıyor.
Aynı incelemede kurallı kontrollerin zayıflığı da ölçüldü: 97 vakalık setin her birine boş bir cevap ve "ekibe aktarıldı" verdik. 97 vakanın 42'si kurallı kontrollerden geçti. Vaka başına beklenen sonuç tanımlanmadığı için devir yapan boş bir cevap birçok vakada "sorun yok" görünüyordu.
Bu düzenle ilk ölçüm: bir klinik sitesinde 24 vakanın 22'si geçti, 2'si kaldı, 0 hata (0,10 dolar). Randevu yolculuğunu adım adım test eden 7 vaka 7'si geçti.
Gürültü: ±1 vaka
Aynı kodu aynı veriyle art arda iki kez koştuğumuzda 15-27 vakalık setlerde sonuç bir vaka oynayabiliyordu (ölçüm). Dört bağımsız vakanın dördü geçse bile %95 güvenle alt sınır yaklaşık %51'dir. "%100 oldu" demek için bu kadar az vaka yetmiyor.
Bu yüzden:
- Küçük farklarla karar vermeden önce aynı koşuyu tekrarlıyoruz.
- Toplam puanın yanında vaka düzeyinde neyin değiştiğine bakıyoruz.
- Kritik vakaları (acil durum, talep onayı) ayrıca birkaç kez koşuyoruz.
Bir örnek bunun neden gerekli olduğunu gösteriyor. Cevap modelinin düşünme seviyesini düşürmeyi denedik. Üç sette toplam sonuç iki ayarda da 55'te 51'di; ayar hızlıydı. Ama tek bir kritik vakada, bir diş çekiminden sonra kanaması durmayan hastaya, düşük ayar bilgi tabanında olmayan "30 dakika ısırın" süresini ekledi. Toplam puan aynıydı; kritik vaka değildi. Ayarı açmadık.
Test setleri de eskiyor
Bir çok turlu randevu setinin başarısı haftalar içinde düştü. Sebep modelde değildi: set bir ay önce yazılmıştı ve içindeki tarihler geçmişte kalmıştı. Bot haklı olarak "bu tarih geçmiş" diyordu. Tarihli vakalar artık göreli yazılıyor ya da düzenli kaydırılıyor.
Bir sesli diyalog testinde de kontrolün kendisi hatalıydı: "İşletme adınızı öğrenebilir miyim?" sorusu ad sorusu sayılıyordu. Ölçüm aracının kodu, ürünün kodu kadar test edilmeli.
Canlı senaryo testi
Bu araçla canlı test hesaplarında 7 işletmede 53 turluk bir senaryo testi koştuk: kafa karıştırıcı sorular, dil değişimi, yanlış ölçütle arama, kural atlatma denemesi. 81 beklentinin 73'ü tuttu. Kalanlardan öğrenilenler:
- Sözlük dil bağımlıydı. "I want to talk to a consultant" insana devir sayılmadı; İngilizce sözlükte "consultant" yoktu.
- Para birimi karıştı. Kaynak "$465,000" diyordu, model "€465,000" yazdı. Uydurma sayı ölçümümüz rakama bakıyor, para birimine bakmıyordu.
- Eski içerik yeni içerikle yarışıyor. Sitenin blog yazılarında eski bir fiyat vardı, fiyat sayfasında yenisi. Bot hangi parçayı çektiyse onu söylüyordu. Bu bir model hatası değil içerik işiydi.
- Belirsiz onayda soru tekrarı. "Hangisi: beyazlatma mı, kaplama mı?" sorusuna "evet" gelince bot doğru olarak kayıt açmadı ama aynı soruyu kelimesi kelimesine tekrarladı.
Kendi değerlendirmenizi kurarken
- Hakeme güvenmeden önce onu ölçün. İnsan etiketli küçük bir set, hakemin nerede yanıldığını gösterir.
- Hakeme modelin gördüğü kanıtın aynısını verin. Eksik kanıt, doğru cevabı uydurma gibi gösterir.
- "Kaldı" kararlarını okuyun. Bizde 8 kararın yalnız 2'si gerçek hataydı.
- Hata ile başarısızlığı ayırın. Hakem ya da altyapı hatası paydadan sessizce düşmemeli.
- Gürültüyü ölçün, kritik vakayı ayrı izleyin. Toplam puan aynı kalırken en önemli vaka bozulabilir.
- Test setini güncel tutun. Tarihler, fiyatlar ve içerik eskir.
Ölçümün sınırları
Setler beş-yedi işletme sitesi ve 24-97 vakadan oluşuyor; genel bir uydurma oranı değil, bu içeriklerde gözlenen sonuçtur. Hakem tek bir model; farklı bir hakem farklı hata desenleri gösterebilir. Kalibrasyon seti küçük ve zamanla genişletilmesi gerekiyor.
Sık sorulan sorular
Bu bölümdeki sorular, aynı konuda en sık arananlardan derlendi.
01Chatbot'un uydurduğu nasıl anlaşılır?
Cevaptaki her somut bilginin (sayı, süre, adres, iletişim bilgisi) modelin o turda gördüğü kaynakta geçip geçmediğine bakılır. Bunu elle yapmak zor olduğu için bir hakem model kullanılabilir; ama hakemin kararları bir süre elle okunarak kalibre edilmelidir.
02LLM hakem (LLM-as-a-judge) güvenilir mi?
Kendi başına değil. Bizim ölçümümüzde hakemin "kaldı" dediği 8 vakanın 3'ü hakemin kendi yanlışıydı: araç sonucunu görmemesi, eksik alıntı, bir sayıyı yanlış okuması. İnsan etiketli bir kalibrasyon seti ve hakeme modelin gördüğü kanıtın aynısını vermek güvenilirliği artırır.
03Hakem model neden cevap modelinden farklı olmalı?
Bir model kendi ürettiği metni yargılarken kendi lehine eğilim gösterebiliyor. Farklı bir sağlayıcının modelini hakem yapmak bu riski azaltır. Bizde cevap OpenAI modelinden, hakem Google modelinden.
04Küçük bir test seti yeterli mi?
Yön göstermek için evet, karar vermek için dikkatli olmak gerekir. 15-30 vakalık setlerde ±1 vaka gürültü olabiliyor. Kritik vakaları birkaç kez koşmak ve toplam puanın yanında vaka düzeyindeki değişime bakmak önerilir.
Mustafa Gürbüz
Dolphy Yöneticisi
Dolphy'nin yöneticisi. Sesli asistan, yazılı sohbet ve bilgi tabanı hattındaki testleri yürütüyor. Yazılardaki sayılar Dolphy'nin kendi test ortamında alınan ölçümlerden geliyor; her yazı ölçümün kapsamını ve sınırını da söylüyor.
İçerik 28 Eylül 2026 tarihinde kontrol edildi
Aynı soruları müşterilere tekrar tekrar yazmayın
Dolphy web sitesi, WhatsApp ve Instagram'da işletmenizin kendi bilgisiyle yanıt verir, talepleri panele düşürür.