İçindekiler13 başlık
Bir müşteri asistanının sistem promptu zamanla büyür. Her canlı hatadan sonra bir kural eklenir, her yeni kanal için bir blok yazılır. Bir noktada prompt, cevap modelinin her turda okuduğu 4-5 bin token'lık bir metne dönüşür.
Model sağlayıcılarının güncel rehberleri tersini öneriyor. OpenAI'nin GPT-5.6 rehberi, sade sistem promptlarının kendi değerlendirmelerinde puanı yaklaşık %10-15 artırıp toplam token'ı %41-66 azalttığını yazıyor. (Bu sonuç kodlama ajanı değerlendirmelerinden.) Biz de promptumuzu farklı biçimlerde yazıp aynı vakalarla ölçtük.
Rehberler ve rakipler ne diyor?
OpenAI, Anthropic ve Google'ın prompt rehberlerini; ElevenLabs, Vapi, Retell ve LiveKit'in sesli ajan rehberlerini; Intercom Fin, Sierra, Decagon, Ada ve Zendesk'in yayımlanmış yaklaşımlarını okuduk. Ortak iskelet şuydu:
- Rol ve amaç (başarı ölçütüyle)
- Kişilik ve ton
- Dil
- Az sayıda değişmez kural
- Araçlar: ne zaman kullanılır, ne zaman kullanılmaz
- Akış ve prosedür
- Belirsizlik ve insana devir
- Kanal biçimi
- İşletme bağlamı ve bilgi kaynakları (belge başına etiketle)
- En sonda tura özel kısım
Rehberlerin iki ortak önerisi daha vardı: "ASLA" ve "HER ZAMAN" gibi kesin ifadeler yalnız gerçek değişmezlerde kullanılmalı; tekrarlanan kurallar ve davranışı değiştirmeyen örnekler ayıklanmalı.
Sektör için bir soru da vardı: çekirdek prompta sektöre özel bir katman eklemeli miyiz? İncelediğimiz kurumsal müşteri hizmeti platformlarında bunun kanıtını bulamadık; sektör bilgisi müşterinin kendi verisinde (bilgi tabanı, prosedür) duruyor. Bu, Dolphy'nin "sektör bilgisi kodda değil, işletmenin bilgi tabanında" kararıyla uyumlu.
Dört sürüm
Kesin kurallar dört sürümde de aynıydı ve iki kanalda (yazılı ve sesli) birebir aynı kaldı. Somut bir işletme örneği hiçbirinde yok.
| Sürüm | Yapı | Sabit kısım (yazılı / sesli, token) |
|---|---|---|
| A | Mevcut prompt | 4.366 / 4.653 |
| B | Standart iskelet, Türkçe, tekrarlar ayıklanmış | 3.826 / 4.118 (−%12) |
| C | B'nin iskeleti İngilizce, cevap misafirin dilinde | 3.062 / 3.354 (−%30) |
| D | Yalın: yalnız değişmezler, doğruluk, talep akışı, araçlar | 2.104 / 2.743 (−%52) |
Aynı model (GPT-5.6 Luna), aynı hakem ve Dolphy'nin kendi test setleriyle:
| Sürüm | Yazılı (14 vaka) | Talep yolculuğu (10 vaka) | Sesli (14 vaka) |
|---|---|---|---|
| A | 13/14 | 6/10 | 14/14 |
| B | 13/14 | 6/10 | 13/14 |
| C | 13/14 | 5/10 | – |
| D | 11/14 | 6/10 | – |
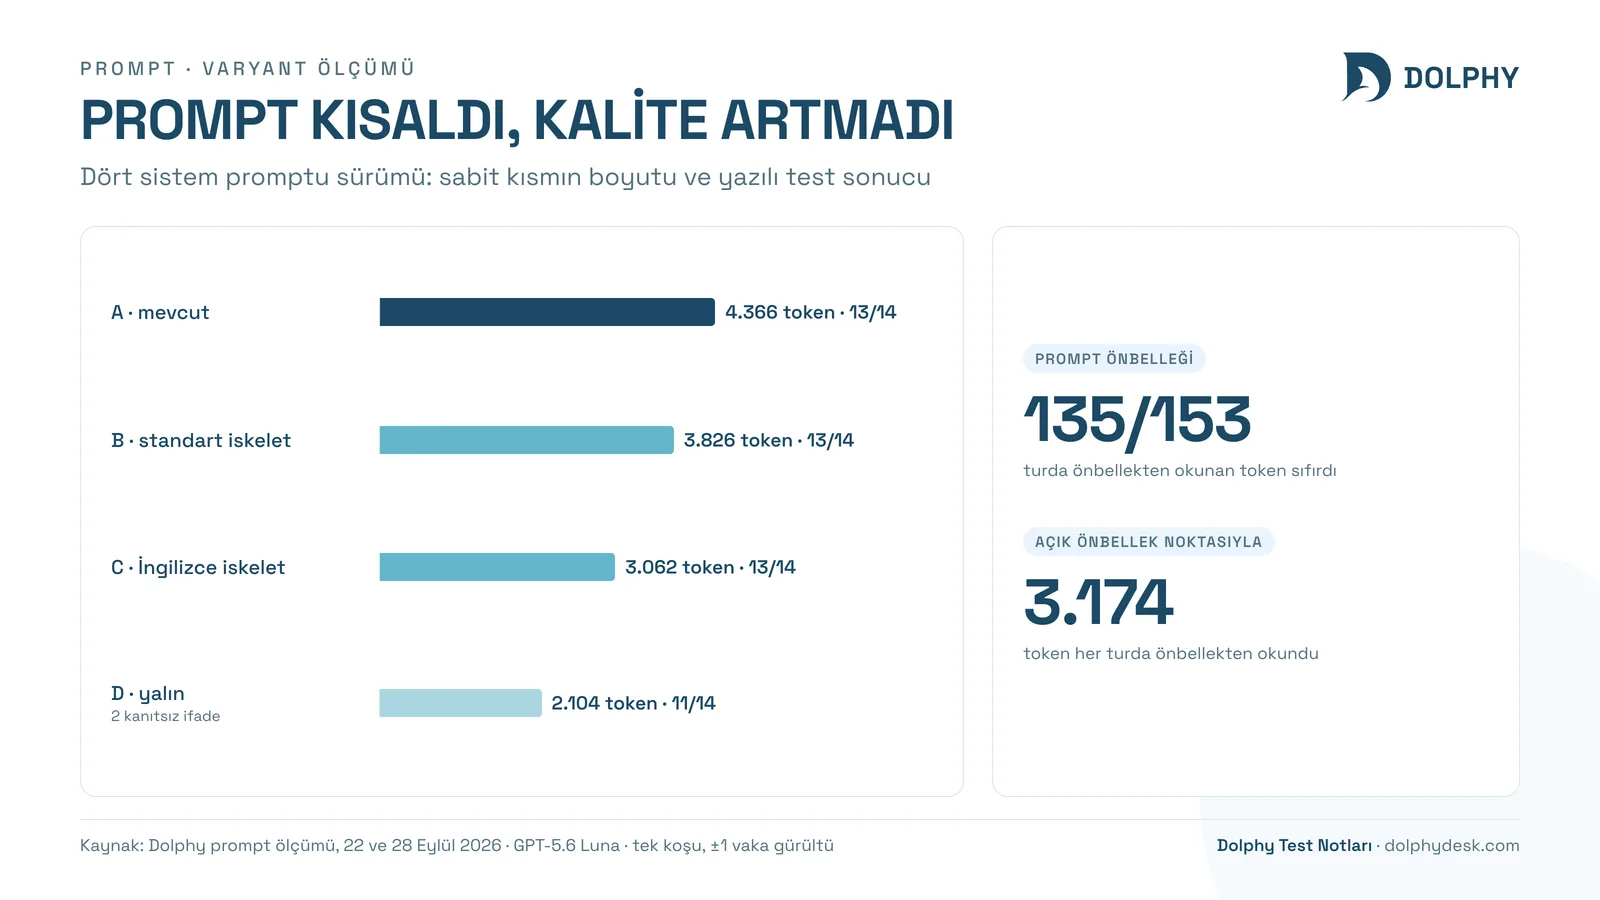
Sonuç: iskelet değişikliği bu sette kaliteyi ölçülebilir biçimde artırmadı. B eşitti, C bir vaka geride kaldı, D iki vakada kanıtsız ifade üretti. Tek koşuda ±1 vaka gürültü olduğu için B ile A arasındaki farklar karar gerekçesi değildi. Kazanç yalnız token'daydı; sesli kanalda B'nin giriş token'ı %5 düşük, gecikmesi aynıydı (p50 1.627 ms'ye karşı 1.659 ms).
Mevcut prompt kaldı. Varyant metinleri depoda saklandı; model ya da test seti değiştiğinde yeniden ölçülebilir.
Dört sürümde de kalan hata: bir "ğ" harfi
Yazılı testte dört sürümde de aynı vaka kalıyordu: aboneliğin iptaliyle ilgili Türkçe bir soruya asistan İngilizce cevap veriyordu. İskeletten bağımsız bir hataydı ve kod tarafındaydı.
Misafirin dilini açıkça belirten kelimeleri bulan kural İngilizce kelimeleri ASCII kelime sınırıyla (\b) arıyordu. "Aboneliği" kelimesindeki "ğ" harfi ASCII'de harf sayılmadığı için kelime sınırı gibi davrandı; sondaki "i" harfi İngilizce "I" zamiri olarak eşleşti ve konuşma İngilizce sayıldı. Sınır artık Unicode harf sınıfıyla kuruluyor. Aynı sınıftan bir hatayı daha önce de yaşamıştık: selamlama tanıyan bir kural "günaydın" ve "nasılsınız" kelimelerini, \w Türkçe harfleri tanımadığı için hiç eşleştirmiyordu.
Talep yolculuğundaki kalan hatalar da prompt iskeletinden değildi. Test seti tarihleri geçmişte kalmıştı ve bot haklı olarak "bu tarih geçmiş" diyordu. Tarihler kaydırılınca A 5/10, B 6/10 verdi; fark yine gürültü düzeyindeydi.
İngilizce prompt Türkçe cevabı iyileştirir mi?
Bazı çalışmalar, ana dil İngilizce olmayan görevlerde İngilizce promptun ortalamada daha iyi sonuç verdiğini gösteriyor. Bu çalışma Arapça sınıflandırma görevlerine dayanıyor. Türkçe lehine bulgular da var ama dar kapsamlı. Bizim görevimiz üslup ağırlıklı Türkçe üretim.
Daha önce takıldığımız vakalarda küçük bir deneme yaptık: aynı bilgi bloğu ve konuşma, yalnız talimat metni Türkçe ya da İngilizce, vaka başına 5 koşu. Liste tavanı iki dilde de 5'te 3 kez aşıldı (İngilizcede bir koşuda 10 madde). Kaynaksız "evet, yapılıyor" iddiası Türkçede 5'te 1, İngilizcede 5'te 2 kez çıktı. İngilizce prompt giriş token'ını yaklaşık %10 azalttı, ilk metin süresi aynıydı. Kalite kazancı olmadığı ve bütün ölçülmüş setlerin yeniden koşulması gerekeceği için geçilmedi.
Asıl kazanç: prompt önbelleği çalışmıyordu
Prompt incelemesinin en değerli bulgusu içerikte değil, önbellekteydi.
OpenAI, tekrar eden prompt önekini önbelleğe alıyor ve okumayı çok daha ucuz faturalıyor. Bizim promptun sabit kısmı (kimlik, kesin kurallar, biçim) her turda bit bazında aynıydı. Kullanım kayıtlarına bakınca bir hafta içindeki 153 cevap turunun 135'inde önbellekten okunan token sıfırdı. Sesli turlarda 114 turun 103'ü önbelleksizdi; ortalama giriş yaklaşık 4.900 token'dı.
Daha önce bunu ölçemiyorduk bile: önbellek alanı kullanım kaydına hiç geçirilmiyordu ve 1.196 satırın hepsinde sıfır görünüyordu. Alan düzeltilince sorun ortaya çıktı.
Sebep OpenAI'nin belgesindeydi: GPT-5.6 ve sonrasında örtük önbellek noktası yalnız son mesajın sonunda oluşuyor. Önbelleğe yazma 1,25 kat, okuma 0,1 kat faturalanıyor. Bizim sistem promptumuz tek mesajdı ve sonunda her turda değişen bilgi bloğu vardı. Her tur bütün promptu önbelleğe yazdırıyor, sonraki tur bu yazılanı hiç okumuyordu.
Aynı isteği farklı düzenlerle yeniden gönderdik (toplam maliyet yaklaşık 0,02 dolar):
| Düzen | 1. tur | 2. tur (farklı bilgi bloğu) |
|---|---|---|
| Tek sistem mesajı | yazma 4.391, okuma 0 | yazma 4.816, okuma 0 |
| İki mesaja bölünmüş | yazma 4.395, okuma 0 | yazma 4.820, okuma 0 |
| Açık önbellek noktası, örtük mod | yazma 4.395, okuma 0 | yazma 1.646, okuma 3.174 |
| Açık önbellek noktası, açık mod | yazma 3.174, okuma 0 | yazma 0, okuma 3.174 |
Prompt metni değişmeden ikiye bölündü: sabit kısım ve bilgi kaynakları. Sabit kısmın sonuna açık bir önbellek noktası kondu. Gerçek hatta 4 soruluk bir testte ilk tur 0, sonraki üç tur yaklaşık 3.167 token'ı önbellekten okudu. Beklenen etki, cevap modelinin giriş maliyetinin ikinci turdan itibaren yarının altına inmesi.
Gecikme kazancını ise ölçmedik: bu promptlarda önbellekli ve önbelleksiz ilk token süreleri gürültü içindeydi (1,7-2,3 sn). Bir kural da buradan çıktı: promptun sabit kısmına her turda değişen bir şey yazılmamalı. Sesli kanalda "şu an açık mısınız?" sorusu için güncel saati prompta eklerken onu sabit kısma değil, tura özel kısma koyduk; aksi hâlde önbellek her dakika bozulurdu.
Kural kopyası ve kanal kısıtları
İki ders daha prompt bakımıyla ilgiliydi.
Kuralın tek kopyası olmalı. Bir dönem sesli ve yazılı kanalın kesin kuralları iki ayrı dosyadaydı. Silinen eski bir şablon dosyası üç gün boyunca hiçbir işletmeye gitmeyen bir prompt metnini test ediyordu. Artık bir test, iki kanalın kesin kural metnini birebir eşitliyor.
Kanal kısıtı modele özgü olabilir. ElevenLabs döneminde sesli promptta "en az 8 kelime" yazıyordu, çünkü o seslendirme modeli kısa metni bekletiyordu (ölçüm). Cartesia hattında bu kural cevapları gereksiz uzatıyordu; orada "en fazla iki cümle ve 25 kelime" oldu. Bir de yerleşim dersi: uzunluk kuralı promptta vardı ama 4 bin karakterlik bilgi bloğu araya girince uyulmuyordu (cevaplar 373 karaktere çıkıyordu). Hatırlatma satırı bilgi bloğunun arkasına, modelin en son okuduğu yere taşınınca uyuldu.
Kendi promptunuzda nasıl uygularsınız?
- Kısaltmayı ölçerek yapın. Rehberlerdeki kazanç sizin görevinize taşınmayabilir; bizde en yalın sürüm uydurmayı artırdı.
- Aynı vakalarla eşleştirilmiş karşılaştırma yapın. Farklı setlerle ölçülen sürümler kıyaslanamaz.
- Kalan hatanın prompttan olduğunu varsaymayın. Dört sürümde de kalan hata bir karakter sınıfı hatasıydı.
- Önbelleğin gerçekten okunduğunu kontrol edin. Kullanım kaydında okunan token sıfırsa sabit kısım her turda yeniden ödeniyordur.
- Değişen bilgiyi promptun sonuna koyun. Saat, geçmiş ve bilgi bloğu sabit kısmın arkasında durmalı.
- Kesin kuralın tek kopyası olsun. İki kanal aynı kurala uyacaksa aynı metni okumalı.
Ölçümün sınırları
Varyant karşılaştırması tek bir işletmenin test setleriyle ve tek koşuyla yapıldı; ±1 vaka gürültü var. İngilizce prompt denemesi vaka başına 5 koşuluk küçük bir yoklama. Önbellek sonuçları OpenAI'nin GPT-5.6 ailesine özgü; başka sağlayıcıların önbellek kuralları farklı.
Sık sorulan sorular
Bu bölümdeki sorular, aynı konuda en sık arananlardan derlendi.
01Sistem promptu kısaltılınca kalite artar mı?
Her zaman değil. Rehberlerde kısaltmanın kaliteyi artırdığı sonuçlar var, ama bizim müşteri asistanı setimizde %12-30 kısalma kaliteyi değiştirmedi, %52 kısalma iki vakada kaynaksız ifadeye yol açtı. Kısaltmanın kesin kazancı token ve maliyet tarafında.
02Türkçe asistan için prompt İngilizce mi yazılmalı?
Bizim denememizde İngilizce prompt giriş token'ını yaklaşık %10 azalttı ama kaliteyi artırmadı; kaynaksız iddia sayısı biraz daha yüksekti. Üslup ağırlıklı Türkçe üretimde Türkçe prompt ve Türkçe örnekler makul bir tercih.
03Prompt önbelleği neden çalışmaz?
En yaygın sebep, promptun sabit kısmının arkasında her turda değişen bir bölüm olması ve sağlayıcının önbellek noktasını mesajın sonunda aramasıdır. Bizim durumumuzda promptu sabit kısım ve değişen kısım olarak ikiye bölüp açık bir önbellek noktası koymak gerekti.
04Prompt önbelleği gecikmeyi azaltır mı?
Sağlayıcılar ilk token süresini de kısalttığını belirtiyor. Bizim promptlarımızda ölçülen fark gürültü içinde kaldı; kesin kazanç maliyet tarafındaydı. Gecikme için kendi trafiğinizde önbellekli ve önbelleksiz turları ayrı ölçmenizi öneririz.
Mustafa Gürbüz
Dolphy Yöneticisi
Dolphy'nin yöneticisi. Sesli asistan, yazılı sohbet ve bilgi tabanı hattındaki testleri yürütüyor. Yazılardaki sayılar Dolphy'nin kendi test ortamında alınan ölçümlerden geliyor; her yazı ölçümün kapsamını ve sınırını da söylüyor.
İçerik 28 Eylül 2026 tarihinde kontrol edildi
Aynı soruları müşterilere tekrar tekrar yazmayın
Dolphy web sitesi, WhatsApp ve Instagram'da işletmenizin kendi bilgisiyle yanıt verir, talepleri panele düşürür.