İçindekiler12 başlık
Her ay yeni bir model çıkıyor ve çoğu "daha hızlı, daha ucuz" diye duyuruluyor. Müşteri asistanında model değiştirmek cazip: sesli kanalda her 200 milisaniye hissediliyor, fatura her konuşmayla büyüyor.
Dolphy'de bir asistanın çalışması için birden fazla model görev alıyor: misafirin mesajını sınıflandıran küçük bir model, cevabı yazan model, site içeriğini işleyen model ve görüşme sonrası analizi yapan model. Bu yazıda bu roller için yaptığımız hız ve kalite ölçümlerini, özellikle de ölçümün bizi yanılttığı anları anlatıyoruz.
"Yeni sürüm daha hızlı" varsayımı
Sesli kanal için ilk ölçüm sunucumuzdan, gerçek sesli promptla, düşünme kapalı ve beşer tekrarla yapıldı:
| Model | İlk yanıt süresi |
|---|---|
| gemini-2.5-flash | 0,42-0,60 sn |
| gpt-4o-mini | 0,48 sn |
| gemini-3.1-flash-lite | 0,49-0,55 sn |
| gemini-3.5-flash-lite | 0,59 sn |
| gpt-4.1-mini | 0,87 sn |
| gpt-5.6-luna | 0,86-1,13 sn |
| gemini-3.6-flash | 0,99-1,21 sn |
Tabloda yeni sürümlerin hızlı olduğuna dair bir desen yok. Bir hafta sonra aynı soruyu kaliteyle birlikte sorduk. Cevap modeli için ilk metin süresi medyanları birbirine yakındı (GPT-5.6 Luna 1.006 ms, gpt-4.1-mini 1.030 ms, gemini-2.5-flash 1.071 ms). Fark başka yerdeydi: bilgi tabanında saat ve adres bilgisi olmayan bir soruda Gemini "24 saat hizmet veriyoruz" ve "adresimiz yok" gibi cevaplar uydurdu; GPT-5.6 Luna ve 4.1-mini "bu bilgi bende yok" dedi. Luna ayrıca %21 daha ucuzdu. Cevap modeli olarak seçildi.
Bu ölçümde bir tuzağı da yakaladık. İlk karşılaştırmayı aynı süreçte arka arkaya koştuk; ikinci model, birincisinin doldurduğu cevap önbelleğini okuyordu. Sonuçlar çöpe gitti ve her model ayrı süreçte yeniden ölçüldü.
SDK ayarı sessizce yok saydı
Birkaç hafta sonra yarı fiyatlı GPT-6 Luna çıktı. İlk ölçüm şaşırtıcıydı: ilk token medyanı GPT-6'da 2.572 ms, GPT-5.6'da 1.038 ms. Yazılı test setinde tur medyanı 4,3 saniyeydi.
Sebep model değildi. Kurulu AI SDK sürümü gpt-6-* adını "düşünmeyen model" sayıyor ve düşünme seviyesi (reasoningEffort) ile hizmet sınıfı (serviceTier) alanlarını hata vermeden atıyordu. Yani GPT-6 her testte varsayılan seviyede, "medium" düşünerek çalıştı; yanıtta düşünme token'ları görünüyordu. SDK güncellenince ve ölçüm doğrudan API'ye yapılınca tablo değişti. Gerçek sesli prompt ve sekiz parçalık bilgi bloğuyla, 10'ar çağrı, sıra dönüşümlü:
| Ayar | İlk token medyanı | p90 | Düşünme token'ı |
|---|---|---|---|
| GPT-5.6 Luna, düşünme kapalı | 951 ms | 1.803 ms | 0 |
| GPT-6 Luna, düşünme kapalı | 890 ms | 2.655 ms | 0 |
| GPT-6 Luna, kapalı + hızlı mod | 669 ms | 1.616 ms | 0 |
| GPT-5.6 Luna, varsayılan | 989 ms | 2.296 ms | 0 |
| GPT-6 Luna, varsayılan (medium) | 3.473 ms | 5.462 ms | 177 |
| GPT-6 Luna, düşük | 1.381 ms | 3.114 ms | 0 |
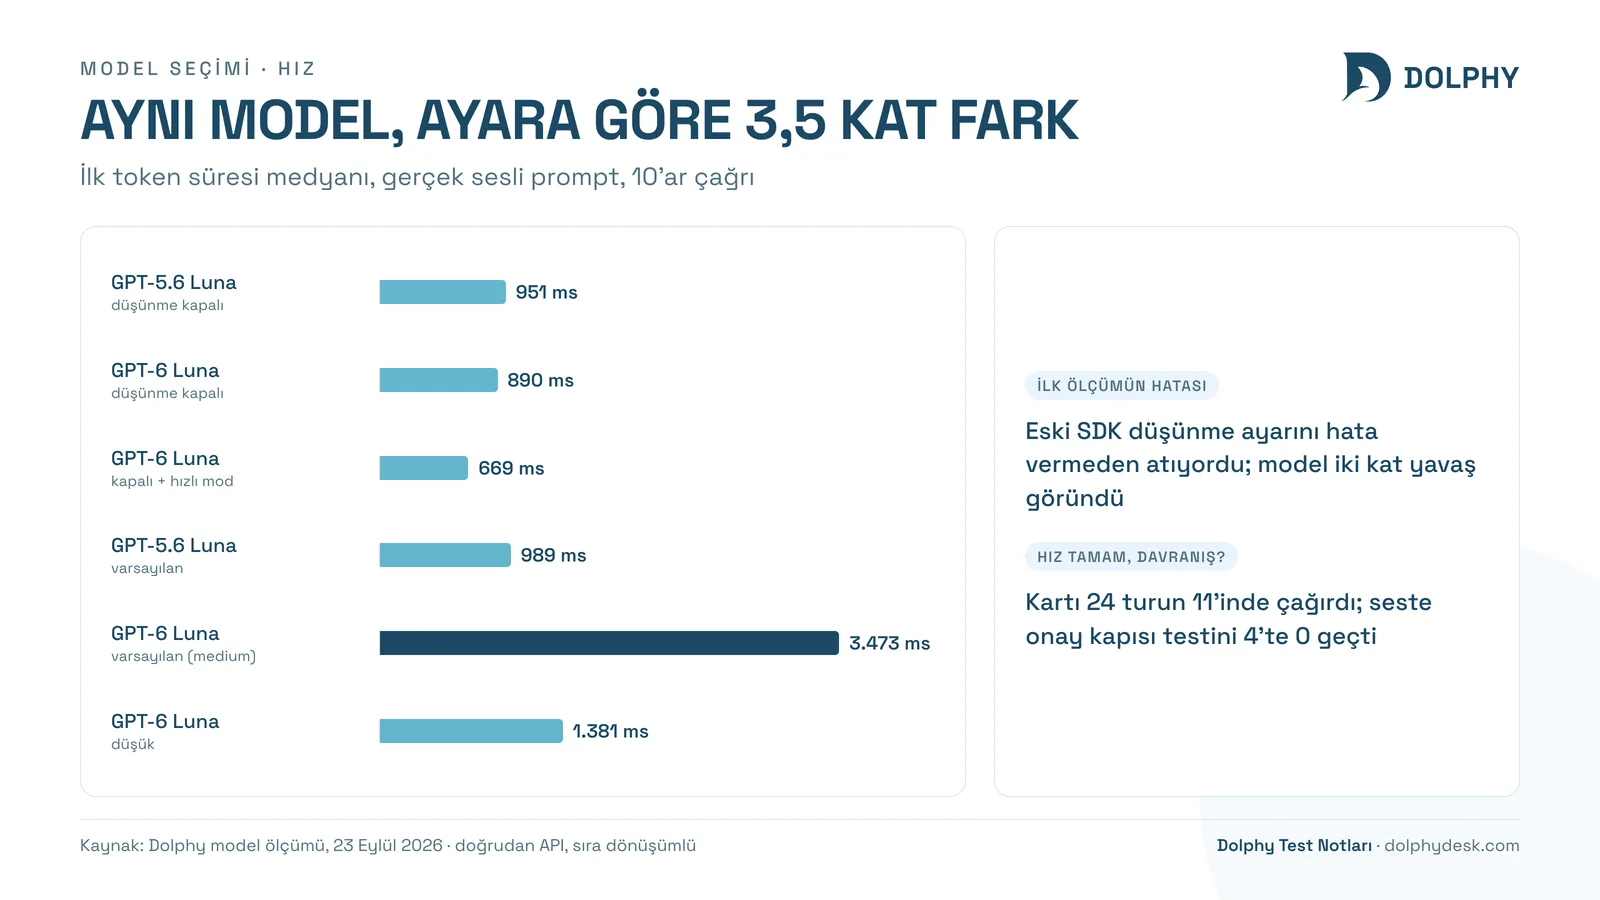
Aynı model, yalnız ayar farkıyla 3,5 kat yavaş. İki ders çıktı:
- Ayarın gerçekten gittiğini doğrulayın. SDK ya da kütüphane bir alanı desteklemiyorsa hata vermeyebilir. Yanıttaki düşünme token sayısı gibi bir kanıta bakın.
- Varsayılan ayarı bilin. GPT-6 Luna'nın varsayılan düşünme seviyesi "medium". Yalnız model adını değiştirmek sesli kanalda düşünmeyi açık bırakır.
Hızlı mod (öncelikli hizmet sınıfı) fiyatı iki katına çıkarıyor. Sesli kanalda sekizinci kelimenin gelme süresine GPT-6 için yalnız ~40 ms kazandırdı; değmedi.
Hız tamam, peki davranış?
Doğru ayarla GPT-6 Luna hızlıydı ve liste fiyatı yarıydı: 1 milyon token için giriş 0,10, çıkış 0,50 dolar (GPT-5.6 Luna 0,20 ve 1,20 dolar). Kalite ölçümü ise başka bir şey gösterdi.
Yazılı kanalda araç kullanımı. GPT-6 sayfa gösterme aracını çok daha sık çağırdı: bir klinik setinde 24 turun 11'inde kart, GPT-5.6'da 0. Her araç çağrısı ikinci bir model adımı demek; tur medyanı 3,0 saniyeden yaklaşık 4,1 saniyeye çıktı ve kart yalnız yönlendirmede gösterilmeli kuralımız (kart yazısı) ihlal edildi.
Sesli kanalda talep onayı. İki kritik vakayı dörder kez koştuk:
| Vaka | GPT-5.6 Luna | GPT-6 Luna |
|---|---|---|
| Onay alınmadan talep açılmamalı | 3/4 | 0/4 |
| Tarih düzeltilince tek, doğru talep | 4/4 | 0/4 |
Bu tablo iki karar doğurdu. GPT-6'ya geçilmedi. Ve GPT-5.6'nın da dört denemenin birinde onaysız talep açtığı görülünce kural koda taşındı (onay kapısı yazısı).
Diğer roller için de GPT-6'yı tek tek denedik:
| Rol | Sonuç |
|---|---|
| Sohbet sınıflandırıcısı | Medyan 1.662 ms, mevcut Gemini modeli 826 ms; 35 turun 27'sinde aynı niyet; bir takip sorusunda bağlamı düşürdü |
| Sayfa sınıflandırma (tarama) | 111 sayfanın 110'unda aynı rol; maliyet üçte bir, süre üç kat |
| Görüşme analizi | Beş konuşmanın beşinde konuyu yanlış etiketledi |
| Denetim raporu | Daha yumuşak puanladı ve iki gerçek bulguyu kaçırdı |
Beş gün sonra yeniden
SDK'lar güncellendikten sonra, aynı gün yayımlanan diğer modellerle birlikte küçük bir karşılaştırma daha yaptık:
| Model | Yazılı (14 vaka) | Yazılı tur p50 | Sesli (14 vaka) | Sesli talep akışı (10) | Seste ilk token p50 |
|---|---|---|---|---|---|
| GPT-5.6 Luna | 14/14 | 2,73 sn | 14/14 | 5/10 | 685 ms |
| GPT-6 Luna | 14/14 | 4,16 sn | 13/14 | 8/10 | 886 ms |
| Gemini 3.5 Flash-Lite | 12/14 | 1,43 sn | 8/14 | – | – |
| Gemini 3.8 Flash (düşük) | 12/14 | 2,20 sn | uygun değil | – | – |
Bu kez GPT-6'nın sesli talep akışı daha iyiydi; 23 Eylül'deki onaysız talep sorunu tekrarlamadı. Ama seste ilk token yaklaşık 200 ms geride kaldı. GPT-5.6'nın talep akışındaki düşük puanın çoğu da modelden değil, hakemin hazır bir duyuru cümlesini çelişkili bulmasından geliyordu. Gemini modelleri hızlıydı ama kaynakta olmayan bilgi söyledi ("destek anında ve gece", "seksen ikiden fazla dil"). Gemini 3.7 ve 3.8 düşünmeyi "düşük"ün altına indirmediği için sesli kanala uygun değildi.
Tek koşuda ±1 vaka gürültü olduğunu bildiğimiz için sonuç "değişiklik yok, GPT-6 aday" oldu. Kısa bir canlı sesli denemede GPT-6, yan konuşma algılayan bekleme aracını yanlış tetikledi ve bir turda 11 saniyelik bir sessizlik oluştu; aynı gün GPT-5.6'ya dönüldü.
Sınıflandırıcı için de aynı turda dört modeli 16 belirsiz ve takip turunda karşılaştırdık:
| Model | p50 | Niyet uyumu |
|---|---|---|
| gemini-2.5-flash (mevcut) | 765 ms | referans |
| gemini-3.5-flash-lite | 885 ms | 13/16 |
| GPT-6 Luna (düşünme kapalı) | 1.583 ms | 15/16 |
| gpt-4o-mini | 1.216 ms | 10/16 |
Mevcut model kaldı. Bir risk not edildi: Google 2.5 ailesini yeni hesaplara açmıyor. Kapanırsa yedek aday 3.5 Flash-Lite, ama geçişten önce niyet setiyle doğrulanmalı.
Düşünme seviyesi: hız mı, doğruluk mu?
Yazılı kanalda cevap modelinin düşünme seviyesini varsayılandan "düşük"e çekmeyi de ölçtük. Üç sette toplam sonuç iki ayarda da 55'te 51'di; ilk metin 150-500 ms erken geliyordu. Beklediğimiz kazanç 1-2 saniyeydi.
Toplamın gizlediği bir vaka vardı: diş çekiminden sonra kanaması durmayan hastanın sorusunda düşük ayar, bilgi tabanında olmayan "30 dakika ısırın" süresini ekledi. Varsayılan ayar "hekimin önerdiği süre boyunca" demişti. Kural netti: yanlış ya da eksik cevap almamak, 1 saniyelik gecikmeden önemli. Ayar açılmadı.
Model seçerken kontrol listesi
- Ayarın gittiğini kanıtlayın. SDK sürümü, düşünme seviyesi ve önbellek seçenekleri sessizce atılabilir. Yanıttaki token dökümüne bakın.
- Her modeli ayrı süreçte ölçün. Paylaşılan önbellek ikinci modele haksız avantaj verir.
- Ortalama yerine dağılıma bakın. Oynak bir model ortalamada hızlı görünüp kuyrukta kaybettirebilir.
- Uydurma testini hız testinin yanına koyun. En hızlı model bilmediği şeyi söyleyebilir.
- Araç davranışını ölçün. Aynı prompt ve araçlarla modeller farklı sıklıkta araç çağırır; bu hem hızı hem kuralları etkiler.
- Kritik vakaları ayrı izleyin. Toplam puan aynı kalırken en riskli vaka bozulabilir.
- Rolleri ayrı değerlendirin. Cevap modeli için iyi olan, sınıflandırıcı ya da analiz için iyi olmayabilir.
Ölçümün sınırları
Ölçümler kendi sunucumuzdan, kendi promptlarımız ve Türkçe test setlerimizle yapıldı; başka bir kurulumda sıralama değişebilir. Test setleri 14-24 vakalık ve tek koşuda ±1 vaka gürültü var. Anthropic ve açık kaynak modeller o dönem hesabımızda anahtar olmadığı için karşılaştırmaya girmedi. Fiyatlar ölçüm tarihindeki liste fiyatları.
Sık sorulan sorular
Bu bölümdeki sorular, aynı konuda en sık arananlardan derlendi.
01Müşteri asistanı için en hızlı yapay zekâ modeli hangisi?
Tek bir cevap yok; hız promptun uzunluğuna, düşünme ayarına ve sağlayıcının o anki yüküne bağlı. Bizim ölçümümüzde düşünme kapalıyken GPT-5.6 Luna ve GPT-6 Luna ilk token'da 0,9-1 saniye civarındaydı; GPT-6 varsayılan ayarında 3,5 saniyeye çıktı. Kendi promptunuzla, dağılıma bakarak ölçün.
02Yeni model çıkınca hemen geçmeli miyim?
Önce kendi test setinizle kaliteyi, araç davranışını ve kritik vakaları ölçün. Bizim deneyimimizde yarı fiyatlı ve hızlı bir model, talep onayı ve kart gösterme gibi kurallarda farklı davrandı ve geçiş ertelendi.
03Düşünme (reasoning) seviyesini düşürmek güvenli mi?
Toplam kalite aynı kalabilir ama tek tek kritik vakalarda fark çıkabilir. Bizim ölçümümüzde düşük seviye bir tıbbi acil durum sorusunda kaynakta olmayan bir süre ekledi. Seviyeyi değiştirmeden önce riskli vakaları ayrıca test edin.
04SDK güncellemesi model ölçümünü etkiler mi?
Evet. Bizim durumumuzda eski SDK yeni modelin adını tanımadığı için düşünme ayarını hata vermeden atıyordu ve model olduğundan iki kat yavaş göründü. Ölçüm öncesi SDK'nın modeli desteklediğini ve ayarların istekte gerçekten yer aldığını doğrulayın.
Mustafa Gürbüz
Dolphy Yöneticisi
Dolphy'nin yöneticisi. Sesli asistan, yazılı sohbet ve bilgi tabanı hattındaki testleri yürütüyor. Yazılardaki sayılar Dolphy'nin kendi test ortamında alınan ölçümlerden geliyor; her yazı ölçümün kapsamını ve sınırını da söylüyor.
İçerik 28 Eylül 2026 tarihinde kontrol edildi
Aynı soruları müşterilere tekrar tekrar yazmayın
Dolphy web sitesi, WhatsApp ve Instagram'da işletmenizin kendi bilgisiyle yanıt verir, talepleri panele düşürür.