İçindekiler14 başlık
Sesli asistanın bir görüşmede yapabileceği en pahalı hata yanlış cevap vermek değil, yanlış kayıt açmaktır. Yanlış ada, yanlış numaraya ya da misafirin onaylamadığı bir tarihe açılan talep, işletmenin ekibine gerçek bir iş olarak düşer.
Dolphy'de bu hataları ölçmek için bir diyalog testi kurduk: canlı cevap hattına, konuşma tanımanın gerçekten ürettiği türden metinler gönderiliyor. Senaryolar bilinen ad, cümle içinde ad, bölünmüş numara, sıfırsız numara, bozuk ad, anlamsız söz, harf harf heceleme ve adını vermeyen misafir. Senaryolardaki ad ve numaralar uydurma. Bu yazı o testlerin ve gerçek test görüşmelerinin öğrettiklerini anlatıyor.
Bir görüşmenin üç ayrı hatası
İncelediğimiz bir görüşmede arayan kişi demo talebi bırakmak istedi ve adını birkaç kez söyledi. Görüşme talep açılmadan bitti. Kayıtları okuyunca üç ayrı katmanda üç ayrı hata çıktı:
- Konuşma tanıma adı bozdu. İlk turda ad doğru yazılmıştı; sonraki turlarda aynı ad her seferinde başka bir biçimde yazıldı.
- Asistan adı zaten biliyordu, yine sordu. İlk turdaki doğru ad kişi kaydına yazılmıştı ama bu bilgi cevap modeline hiç gitmiyordu. Talep aracı da "ad soyad" istiyordu; misafir soyadını söylemeyince ad eksik sayılıyordu. 10 haneli bir cep numarası da "eksik" bulundu.
- Panelde hayalet cevaplar vardı. Çerçeve her kesin yazıda cevabı önden üretmeye başlıyor, misafir konuşmaya devam edince bu üretimi iptal ediyor. İptal edilen cevaplar da kayda yazılıyordu. On saniyelik bir aralıkta kayıtta üç asistan cevabı vardı; misafir bunların yalnız birini duymuştu. Sonraki tur bu geçmişi okuduğu için model duyulmamış cümlelere göre konuşuyordu.
Konuşma tanıma kalitesini ayrı bir karşılaştırmada ele aldık. Bu yazı diğer iki katmanla ilgili: bilinen bilgiyi kullanmak ve neyin gerçekten duyulduğunu bilmek.
Bilinen bilgiyi modele vermek
İlk düzeltme basitti ama etkisi büyüktü: görüşmeye bağlı kişinin adı, telefonu ve e-postası promptun tura özel kısmına yazılıyor. Bilinmeyen alan "bilinmiyor" diye geçiyor. Aynı satır, bilgi kaynaklarında geçen numaraların işletmeye ait olduğunu da söylüyor.
Birkaç kural daha eklendi:
- Soyad zorunlu değil. Talebi açmak için ad yeterli.
- Bozuk ya da çelişen ad kaydedilmiyor, doğrulanıyor. İki denemeden sonra harf harf isteniyor, yine olmazsa görüşme adsız devam ediyor.
- Parça parça gelen rakamlar tek numara sayılıyor. Türk cep numarası 10 hane, ülke kodu istenmiyor.
- İşletmenin kendi numarası misafir numarası sayılmıyor. Bot kaynaklarda gördüğü işletme numarasını misafirinki sanıp talebe yazamıyor.
- Misafirden "yazmasını" istemiyor. Sesli görüşmede anlamsız bir istek.
Talebi yalnız onaydan sonra açmak
Talep akışının kuralı promptta açıkça yazılıydı: eksik bilgiyi topla, özeti oku, "Onaylıyor musunuz?" diye sor, onay gelince talebi aç. Model bu kurala çoğu zaman uyuyordu. Test koşularında ise uymadığı anlar görüldü. Bir diyalog testinde bot özet ve onay sormadan talep açtı; talep bildirimi ekibe e-posta olarak gitti.
Farklı modellerle aynı iki kritik vakayı dörder kez koştuk:
| Vaka | GPT-5.6 Luna | GPT-6 Luna |
|---|---|---|
| Onay alınmadan talep açılmamalı | 3/4 | 0/4 |
| Tarih düzeltilince tek, doğru talep açılmalı | 4/4 | 0/4 |
Yeni model ikinci vakada önce eski tarihli talebi, sonra doğrusunu açıyordu; panelde çift talep oluşuyordu. Ama tablonun asıl dersi soldaki 3/4'tü: kullandığımız model de dört denemenin birinde onay almadan talep açmıştı. Kural yalnız promptla korunuyordu.
Kuralı koda taşıdık. İlk talep yalnız şu koşulda açılıyor: önceki asistan mesajı bir özet ve onay sorusuyla bitmiş olmalı, son cümlesi bilgi istememeli. Misafirin cevabı bir numara ya da e-posta taşıyorsa talep açılmıyor, çünkü bu durumda misafir hâlâ bilgi veriyor demektir. Bu kapı hem mevcut modeldeki riski kapattı hem de ileride model değiştirmenin önündeki engeli kaldırdı.
Kısa bir söz ad sanılabilir
Sesli görüşmenin açılışında asistan adı soruyor. İlk turda gelen kısa bir cevap ("Ayşe", "Ben Mehmet") ad olarak kaydediliyor ve asistan hazır bir cümleyle karşılık veriyor. Bu hızlı yol üç hata çıkardı:
- Anlamsız söz ad oldu. Gürültülü bir ortamda konuşma tanıma "Ya, cips." yazdı; kural bunu "Cips" adı olarak kaydedebiliyordu. Artık sesli kanalda yalnız açılış turundan gelen ad bir tahmin sayılıyor ve onaylanan talepteki adla değişebiliyor.
- Soru ad oldu. Bir testte ilk söz "adresiniz nerede" idi; konuşma tanıma soru işareti koymadı ve asistan "Memnun oldum Adresiniz Nerede" dedi. Soru sözcükleri ve "-ınız/-iniz" iyelik ekiyle biten kelimeler artık ad sayılmıyor. Son 60 günün 38 gerçek ilk cümlesinde eski ve yeni kural aynı sonucu verdi, yani kural başka bir şeyi bozmadı.
- Sorulmamış söz ad oldu. Misafir asistanın sözüne girip "dışarı arama" dedi, konuşma tanıma bunu bir kişi adına benzetti ve asistan "İsminizi … olarak mı alayım?" diye sordu. Prompttaki "bozuk adı doğrula" kuralı ad sorulmamışken de uygulanıyordu. Kuralı daraltmak tek başına yetmedi (bir yoklamada 1/4 → 0/4, diğerinde 2/4 → 2/4). Model kuraldaki örnek adı da kopyalıyordu. Belirleyici çözüm kod tarafındaydı: söz tek başına bir ada benziyor ama asistanın son cümlesi ad sormuyorsa, o tura "büyük ihtimalle yanlış duyuldu, ad sayma, ne dediğini sor" notu ekleniyor. Sonuç iki yoklamada 0/5 ve 0/5 oldu; ad sorulduğunda ad yine kabul ediliyor.
Hitap için ayrıca bir kural var: asistan "Bey" ya da "Hanım" demek için addan cinsiyet tahmin etmiyor. Ad kapalı bir sözlükte varsa unvan ekleniyor, yoksa yalın ad kullanılıyor. Sesten cinsiyet çıkarmayı da elediğimizi not edelim: AB Yapay Zekâ Tüzüğü bunu biyometrik kategorizasyon sayıyor ve yüksek riskli sınıfa koyuyor.
Söz kesilince neyi duydu?
Misafir asistanın sözüne girdiğinde asistan susuyor. Ama cevap hattı cevabın tamamını üretmiş ve kaydetmişti. Sonraki tur bu tam metni geçmişte görüyordu. Somut bir örnek:
- Asistan: "Talebinizi özetleyeyim: yarın saat 14:00, iki kişi. Onaylıyor musunuz?"
- Misafir, "yarın saat" kısmında söze giriyor: "Pardon, yarın değil."
Kayıtta tam metin durduğu için onay kapısı "Onaylıyor musunuz?" sorusunu sorulmuş sayıyordu. Misafirin sonraki "evet"i, hiç duymadığı bir özeti onaylamak gibi okunabilirdi.
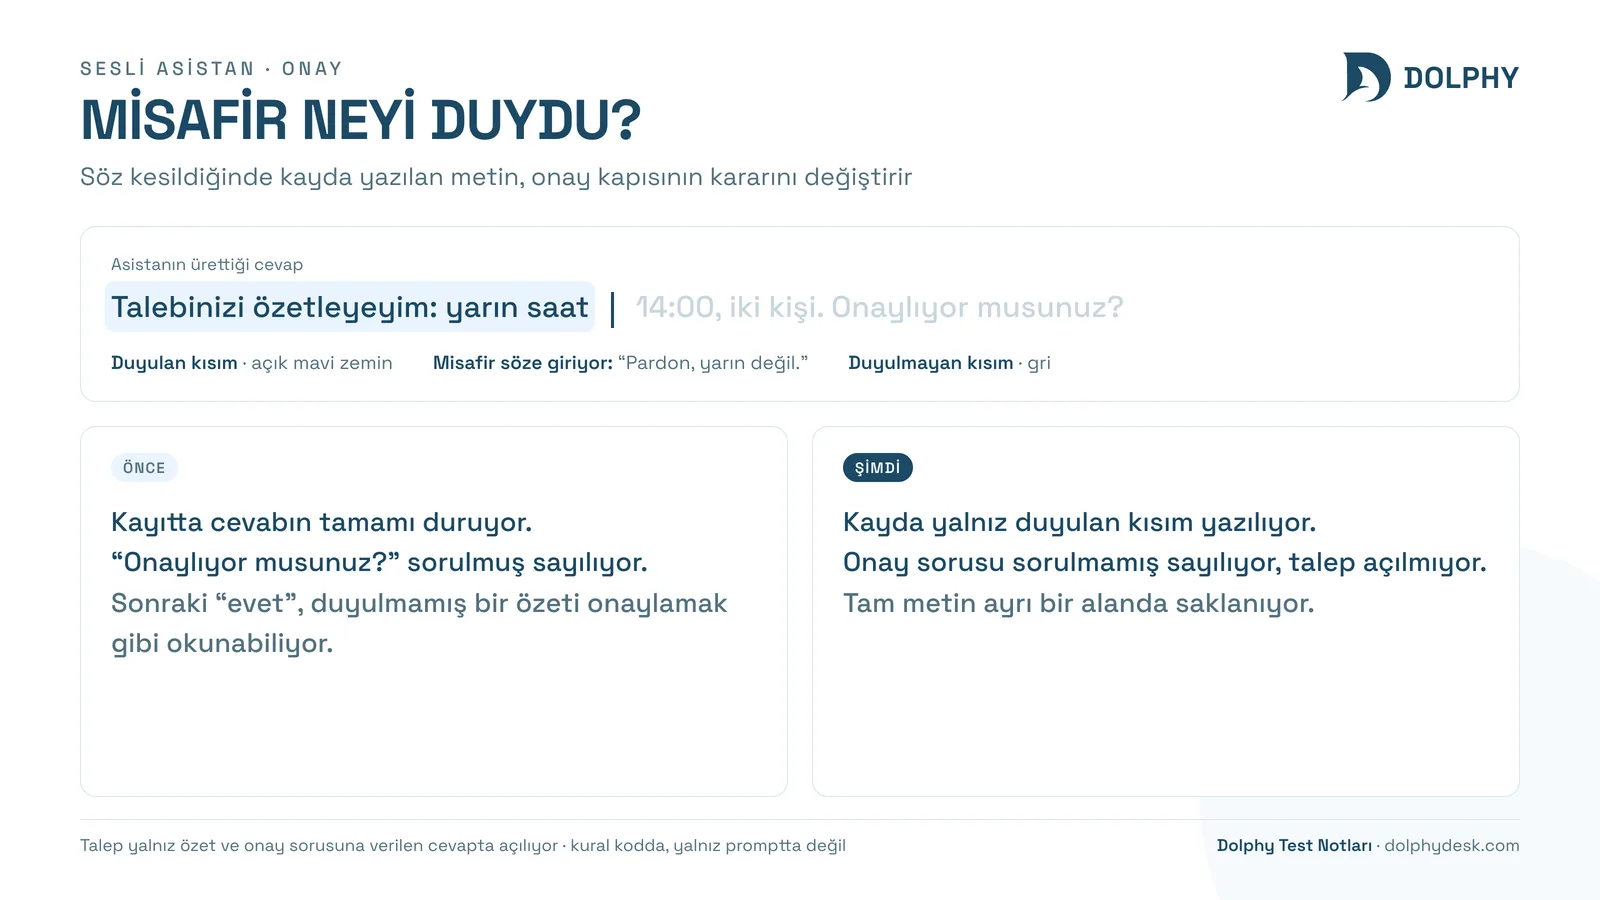
Artık söz kesildiğinde cevap hattına ve kayda yalnız duyulan kısım gidiyor; tam metin ayrı bir alanda saklanıyor. Rakip platformlarda aynı desen var: OpenAI'nin gerçek zamanlı API'si kesilen cevabı bağlamdan kırpıyor, Deepgram söylenen ve söylenmeyen metni ayrı döndürüyor.
Bu düzeltmenin doğrulaması iki hata yakaladı. Kesilen cevap kaydedilmemişse (akış yarıda koptuysa), düzeltme bir önceki tam duyulmuş cevaba uygulanıp onu kısaltabiliyordu; artık yalnız son asistan mesajından sonra misafirin başka sözü yoksa uygulanıyor. Seslendirme dönüşümü metni değiştirdiği için ("+90" → "0") eşleşme hiç tutmuyordu; artık yalnız harf ve rakamlar karşılaştırılıyor.
Bir sınır da açık: duyulan kısım çerçevenin tahmini. Çerçeve metni sesin gerçek zamanlamasına göre değil sabit bir hızla ilerletiyor ve heceyi İngilizce sayıyor. Türkçe ve rakamlı cevapta tahmin sesin yaklaşık 0,8-1,4 saniye önüne geçebiliyor. Yine de tam metni kaydetmekten her zaman daha doğru.
Önbellek de kişisel bilgi taşıyabilir
Sesli kanalda aynı soruya verilen cevap kısa süre önbellekte tutuluyor. İnceleme sırasında bir risk gördük: arayanın adını ya da telefonunu içeren bir cevap önbelleğe girerse, aynı soruyu soran başka bir arayana okunabilirdi. Kişisel bilgi geçen cevaplar ve sayfa kartı taşıyan cevaplar artık önbelleğe yazılmıyor; telefon ve web hatları da ayrı tutuluyor.
Sonuçlar ve kalan açık
Diyalog testinin ilk koşusu 16 kontrolün 11'ini geçti; kontrol kurallarının birinde de hata vardı ("işletme adınızı" sorusu ad sorusu sayılıyordu). Onay kapısından sonra 24'te 19'a çıktı. Son koşuda 8 senaryonun 7'si geçti.
Kalan açık harf harf heceleme: 4 denemenin 2'si geçti. Bir denemede şehir adlarıyla heceleme ("C Ceyhan, A Adana…") yan konuşma sanıldı ve tur cevapsız kaldı; bir denemede model heceden başka bir ad kurdu. Önerilen çözüm hecelemeyi modele bırakmadan harfleri kodla birleştirmek.
Kendi hattınızda nasıl uygularsınız?
- Kritik kuralları promptta bırakmayın. Onay almadan kayıt açmamak gibi kurallar kodla korunmalı; en iyi model bile dört denemenin birinde kaçırabiliyor.
- Bilinen bilgiyi modele verin. Kaydedilmiş adı yeniden sormak misafire duyulmadığını hissettirir.
- İptal edilen üretimi kaydetmeyin. Önden üretim kullanıyorsanız, misafirin duymadığı cevap geçmişe girmemeli.
- Söz kesilince yalnız duyulan kısmı saklayın. Aksi hâlde model misafirin hiç duymadığı soruya cevap alındığını sanır.
- Hızlı yolları dar tutun. "İlk turdaki kısa söz addır" gibi kısayollar soru, gürültü ve söze girmede yanlış çalışır.
- Test verisinde gerçek kişi kullanmayın. Canlı hatta koşan testler gerçek talep ve e-posta üretebilir.
Ölçümün sınırları
Diyalog testi yazılı metinle koşuyor; konuşma tanıma, seslendirme ve tur kararını içermiyor. Kontrol edilen tur sayısı sınırlı ve bazı turlar kontrolsüz. Model karşılaştırması iki vakada dörder denemeyle yapıldı; oran değil yön gösterir.
Sık sorulan sorular
Bu bölümdeki sorular, aynı konuda en sık arananlardan derlendi.
01Sesli asistan yanlış adı nasıl kaydeder?
Genellikle üç yoldan: konuşma tanıma adı yanlış yazar, kısa bir söz (gürültü, soru, konu adı) ad sanılır ya da doğrulanmamış bir ad kayda geçer. Adı sesli olarak doğrulatmak ve ilk turdan gelen adı yalnız tahmin saymak bu riski azaltır.
02Talep açmadan önce onay almak neden kodla korunmalı?
Çünkü model bu kurala her zaman uymuyor. Bizim testimizde kullandığımız model dört denemenin birinde onaysız talep açtı; daha yeni bir model dördünde de açtı. Kurallı bir kapı, önceki asistan mesajı özet ve onay sorusu değilse talebi açmıyor.
03Söz kesildiğinde transkripte ne yazılmalı?
Misafirin gerçekten duyduğu kısım. Tam cevabı yazmak, sonraki turda modelin duyulmamış bilgiye göre konuşmasına ve onay kontrollerinin yanlış çalışmasına yol açar. Tam metin gerekirse ayrı bir alanda saklanabilir.
04Harf harf heceleme sesli asistanda çalışır mı?
Kısmen. Bizim testimizde 4 denemenin 2'si geçti. Şehir adlarıyla heceleme bazen yan konuşma sanıldı. Harfleri modele yorumlatmak yerine kodla birleştirip modele hazır ad olarak vermek daha güvenilir görünüyor.
Mustafa Gürbüz
Dolphy Yöneticisi
Dolphy'nin yöneticisi. Sesli asistan, yazılı sohbet ve bilgi tabanı hattındaki testleri yürütüyor. Yazılardaki sayılar Dolphy'nin kendi test ortamında alınan ölçümlerden geliyor; her yazı ölçümün kapsamını ve sınırını da söylüyor.
İçerik 28 Eylül 2026 tarihinde kontrol edildi
Aynı soruları müşterilere tekrar tekrar yazmayın
Dolphy web sitesi, WhatsApp ve Instagram'da işletmenizin kendi bilgisiyle yanıt verir, talepleri panele düşürür.