İçindekiler14 başlık
RAG hatlarında sık önerilen bir adım var: arama 30-50 aday getirir, bir çapraz kodlayıcı (cross-encoder) model bu adayları soruya göre yeniden sıralar ve en iyi 8'i modele verir. Buna rerank deniyor. Anthropic'in bağlamlı arama çalışmasında rerank, bağlamlı embedding'in üstüne ek kazanç sağlıyor.
Dolphy'de rerank'i yazdık, açtık, ölçtük ve kapattık. Bu yazı o kararın sayıları ve yerine ne yaptığımız.
Önce maliyet hesabı
Kullandığımız çok dilli rerank modelinin fiyatı 1 milyon token başına 0,02 dolardı. Faturalama sorgu artı her adayın tamamı üzerinden. 30 aday ve 200-800 token'lık parçalarla sorgu başına maliyet 0,00012 ile 0,00048 dolar arasında çıktı. Rerank yalnız bilgi tabanına giden turlarda çalıştığı için işletme başına aylık tahmin 0,10-2 dolardı. Başka bir sağlayıcı arama başına faturalıyordu ve bizim parça boylarımızda yaklaşık 7 kat pahalıydı.
Maliyet sorun değildi. İlk açışta rerank'i yine de açmadık, üç gerekçeyle:
- Test işletmelerinin bilgi tabanı 20-50 parçaydı; 40'lık aday havuzu neredeyse bütün bilgi tabanıydı. Az aday arasından yeniden sıralamanın kazancı sınırlı.
- Aynı turda altı retrieval değişikliği yapılmıştı. Rerank de açılırsa hangisinin ne yaptığı ölçülemezdi.
- Sesli turda 100-200 ms ek gecikme.
Açınca ne oldu?
Sonraki ölçümlerde rerank açıktı. İki şey öğrendik.
Rerank bedava bir kazanç değil. Bir sette isabeti artırdı (otel %75 → %92), başka bir sette düşürdü (emlak %100 → %93).
Ücretsiz kotayı değerlendirme koşuları tüketti. Sağlayıcının 10 milyon token'lık ücretsiz kotası bittiğinde çağrıların 1.793'ünün 1.535'i test koşularıydı. Kota bitince her yazılı tur 403 hatası alıyor, hata yutulup eski sıraya düşülüyordu. Ama tur hatayı beklerken gecikme ödüyordu ve kullanım kaydı rerank'i "çalıştı" diye yazıyordu. Bu kayıt da düzeltildi.
Soru "kota alalım mı" değil, "hâlâ gerekli mi" oldu. Rerank kapalıyken üç sette ölçtük:
| Set | Rerank açık | Rerank kapalı |
|---|---|---|
| E-ticaret (27 vaka) | %96 / 0,806 | %96 / 0,852 |
| Emlak (17 vaka) | %100 / 0,890 | %100 / 0,870 |
| Otel (15 vaka) | %93 / 0,724 | %87 / 0,639 |
(İlk 8 isabeti / MRR.) 59 vakada rerank'in kurtardığı vaka 1'di: otel setinde bir oda sorusu. Kapatmanın kazancı her yazılı turda 668 ms oldu.
Rerank'siz, rerank'in üstüne
Otelin tek kaybını veriyle inceledik. Sebep rerank'in yokluğu değil, iki mekanik hataydı:
- Aday havuzu rerank'e bağlıydı. Rerank açıkken veritabanından 30 aday isteniyordu. Kapanınca havuz 8'e düştü ve sonraki adımlar yalnız eleyebiliyordu.
- Ana sayfanın beş URL kopyası vardı. 8 yuvanın 4'ü aynı metne gidiyordu. Farklı bilgi taşıyan parçalar listeden itiliyordu.
Havuz artık her zaman 30. Taramanın ikinci aşaması aynı içerik özetini taşıyan sayfaları tekilleştiriyor (otel sitesinde 43 parçadan 31'e). Sonuç:
| Set | Rerank açık | Rerank kapalı + iki düzeltme |
|---|---|---|
| E-ticaret | %96 / 0,806 | %100 / 0,858 |
| Emlak | %100 / 0,890 | %100 / 0,870 |
| Otel | %93 / 0,724 | %100 / 0,719 |
Kendi sunucumuzda açık kaynak bir rerank modeli çalıştırmayı da değerlendirdik. Türkçe bilen modeller (bge-reranker-v2-m3, gte-multilingual, Qwen3-Reranker 0.6B) 4 çekirdekli, GPU'suz sunucuda 30 adayı saniyeler içinde sıralıyordu. Yarım saniyede biten tek model Türkçe eğitim verisi görmemişti. Bu yol elendi.
Ölçüm gürültüsü: ±1 vaka
Bu turun belki de en önemli bulgusu bir yan ürün oldu. Parçalama kuralını değiştirdikten sonra e-ticaret seti %93 / 0,773 verdi ve bunu bir gerileme saydık. Aynı kod, aynı veriyle art arda iki koşu yaptık: %96 / 0,788 ve %93 / 0,807. Rerank modeli turdan tura aynı sırayı vermiyordu.
Sonuç: 15-27 vakalık setlerde ±1 vaka ve ±0,03 MRR gürültüdür. Bu ölçüme kadar tek koşudan karar verdiğimiz bir ayar (sayfa başına parça tavanı) geri alındı; farkın kanıt olmadığı anlaşıldı. O günden sonra kritik kararlar ya belirleyici (deterministik) ölçümle ya da tekrarlanan koşuyla veriliyor.
RRF yerine kalibre füzyon
Hibrit aramanın iki kolu var: vektör (anlam) ve sözcüksel (kelime). İki listeyi birleştirmenin en yaygın yolu RRF (Reciprocal Rank Fusion): her aday için yalnız sıraya bakan bir puan. Skorun kendisi atılıyor.
Literatür bu konuda net: Bruch, Gai ve Ingber'in 2023 çalışması skorları normalize edip ağırlıklı toplayan yöntemin (convex combination) RRF'i geçtiğini gösteriyor. Weaviate 1.24'te varsayılanı göreli skor füzyonuna çevirdi. VectorChord'un ölçümü, sözcüksel kol zayıfken RRF'in yalnız vektör aramasının bile altında kalabildiğini gösteriyor. Bizim durumumuz buydu: sözcüksel kol Türkçe doğal sorularda zayıftı (ayrıntı).
Beş farklı işletme sitesinde 128 soruluk bir sıralama seti kurduk (27'si bilgi tabanında cevabı olmayan soru). Soru türleri olgu, politika, eş anlamlı, ürün, sayı, Türkçe karaktersiz yazım, yazım hatası, İngilizce, uzun soru, tam ad, kod, liste ve karşılaştırma. Laboratuvar aracı adayları ve embedding'leri önbellekten okuyor; model ya da veritabanı çağırmadan farklı birleştirme yöntemlerini karşılaştırabiliyor. Eski yolun simülasyonu gerçek aramayla 128 sorunun 126'sında aynı ilk parçayı verdi, yani laboratuvar gerçeği yansıtıyordu.
101 cevaplı soruda sonuç:
| Yöntem | İlk 8 isabet | İlk sıra isabet | MRR |
|---|---|---|---|
| Eski yol (RRF) | %97 | %81 | 0,876 |
| Yalnız vektör | %99 | %84 | 0,896 |
| RRF, iki kol tek birleşim | %97 | %80 | 0,868 |
| Min-max normalize, ağırlıklı toplam | %99 | %83-85 | 0,894-0,903 |
| Kalibre toplam, α = 0,8 | %99 | %86 | 0,911 |
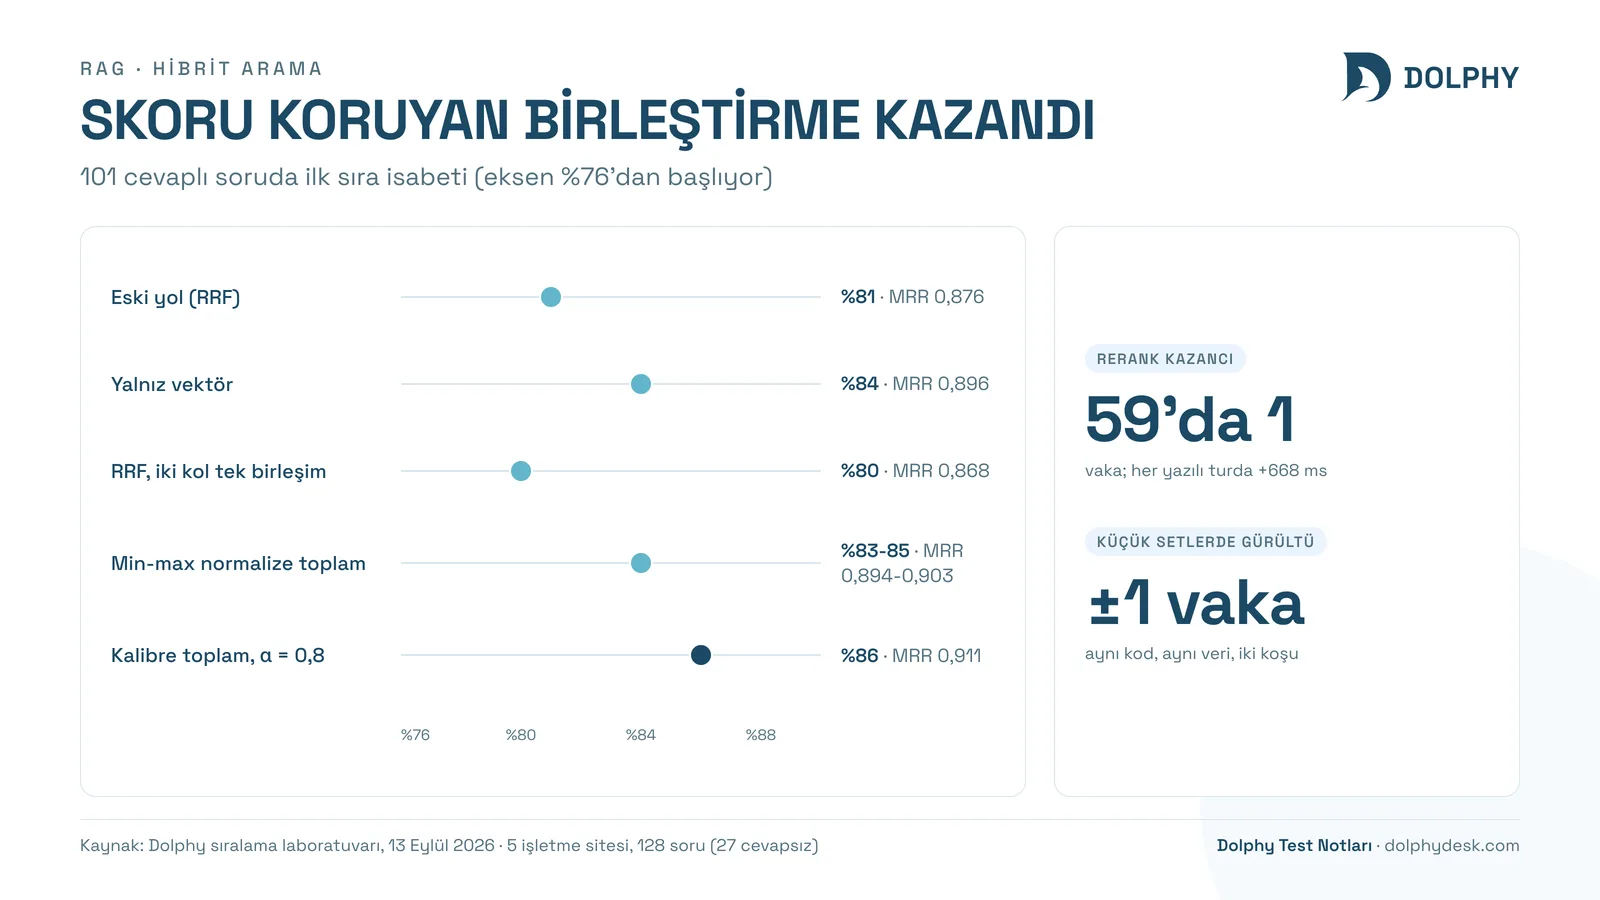
α 0,6 ile 0,9 arasındaki fark ±0,01'di, bir vaka düzeyinde. Modele bağlı sabit içermeyen ve literatürdeki değere yakın varyant seçildi. Vaka düzeyinde 14 soru iyileşti, 7 soru bir-iki basamak geriledi. "Paketleriniz ve fiyatları" sorusunda doğru sayfa 6. sıradan 1. sıraya çıktı. Değişiklik bir gerileme testiyle korunuyor: sabit aday dosyası üzerinde sıralama değişirse test kırılıyor.
"Bilgi yok" kararı ham benzerliğe bağlanmamalı
Dolu bir bilgi tabanında arama hiç boş dönmüyor; her soruya en yakın bir şey bulunuyor. Bu yüzden bot "bende bu bilgi yok" dediğinde bile arama "sonuç var" diyordu ve destek önerisi gösterilmiyordu.
Embedding benzerlikleri modele göre farklı bir tabana oturuyor (anizotropi); hiçbir rakip "yok" kararını ham kosinüs değerine bağlamıyor. Biz en iyi benzerliğe küçük bir kapsama puanı ekleyen bir sinyal kurduk ve eşiği kullandığımız embedding modeli için ayrı belirledik. 128 soruda (27 cevapsız) sinyalin ayırma gücü AUC 0,91 çıktı. İşaretlediği 15 sorunun 14'ü gerçekten cevapsızdı (kesinlik %93), ama cevapsız soruların yalnız %52'sini yakaladı. Sinyal cevabı kısıtlamıyor; yalnız "bilgi yok" durumunda destek yolunu gösteriyor.
Sorgu hızı: indeks kullanılmıyordu
Aramanın veritabanı tarafında da bir ölçüm bulgusu vardı. Vektör indeksinin (HNSW) tarama sayısı sıfırdı; hiç kullanılmamıştı. İki sebep çıktı. Sorgu, embedding kolonu dahil bütün satırı bir ara tabloya kopyalıyordu; ara tablo üzerinde indeks kullanılamaz. Şekil düzeltilince de planlayıcı indeksi seçmedi: fonksiyon genel planla planlanıyor ve işletme filtresi için satır sayısını olduğundan az tahmin ediyordu.
Vektör aşaması ayrı bir fonksiyona alındı. 2.911 parçalı bir sitede sıcak sorgu 30,4 ms'den 4,4 ms'ye, soğuk bağlantıda 2.806 ms'den 259 ms'ye indi. Kalite değişmedi; indeks yalnız kaybettirebilirdi, kaybettirmedi. İndeks kurulum parametresini yükseltmek (daha iyi recall için) ise yazmayı veritabanı zaman aşımına çarptırdı ve geri alındı. Okumayı iyileştiren ayarın faturası yazma tarafına çıkabiliyor.
Kendi aramanızda nasıl uygularsınız?
- Rerank'i ölçmeden açmayın. Az adaylı bilgi tabanında kazanç sınırlı olabilir; bedeli gecikme.
- Rerank kapatınca aday havuzunun küçülüp küçülmediğine bakın. Bizdeki kaybın sebebi rerank değil havuz boyuydu.
- Kopya sayfaları tekilleştirin. Aynı metnin URL kopyaları sonuç yuvalarını boşa harcar.
- Gürültüyü ölçün. Aynı koşuyu iki kez yapmadan küçük farklara karar vermeyin.
- Skoru atan birleştirmeyi sorgulayın. Kollardan biri zayıfsa RRF, iyi olan kolu da aşağı çekebilir.
- Laboratuvarınızı gerçeğe bağlayın. Simülasyonun gerçek aramayla aynı sonucu verdiğini bir kez doğrulayın.
Ölçümün sınırları
Sıralama seti 128 soru ve beş site; sonuçlar bu içerik tiplerine özgü. Rerank ölçümü tek bir sağlayıcının çok dilli modeliyle yapıldı; daha yeni ya da farklı modeller farklı sonuç verebilir. Test işletmelerinin bilgi tabanları küçük-orta ölçekliydi; binlerce sayfalık bir katalogda rerank'in değeri değişebilir.
Sık sorulan sorular
Bu bölümdeki sorular, aynı konuda en sık arananlardan derlendi.
01RAG'de rerank her zaman gerekli mi?
Hayır. Rerank çok sayıda aday arasından ayıklamada değerlidir. Bilgi tabanı küçükse ya da aday havuzu bilgi tabanının büyük kısmını kapsıyorsa kazanç sınırlı kalabilir. Bizim ölçümümüzde 59 vakada 1 vaka kurtardı ve her tura 668 ms ekledi.
02RRF mi, ağırlıklı skor toplamı mı?
Kollarınızdan biri zayıfsa skoru koruyan birleştirme daha iyi sonuç verebilir. Bizim 101 soruluk setimizde kalibre toplam, ilk sıra isabetini RRF'e göre %81'den %86'ya çıkardı. Kendi setinizde iki yöntemi aynı adaylarla karşılaştırmanızı öneririz.
03Küçük test setlerinde fark ne zaman anlamlıdır?
15-27 vakalık setlerde ±1 vaka ve ±0,03 MRR bizim ölçümümüzde gürültü çıktı. Aynı kodu iki kez koşup farkı görmeden karar vermeyin. Belirleyici (rastgelelik içermeyen) ölçümler bu gürültüyü azaltır.
04Kendi sunucumda rerank modeli çalıştırabilir miyim?
GPU'nuz varsa evet. Bizim 4 çekirdekli, GPU'suz sunucumuzda Türkçe bilen rerank modelleri 30 adayı saniyeler içinde sıraladı; sesli asistan gibi gerçek zamanlı bir kullanımda kabul edilemezdi.
Mustafa Gürbüz
Dolphy Yöneticisi
Dolphy'nin yöneticisi. Sesli asistan, yazılı sohbet ve bilgi tabanı hattındaki testleri yürütüyor. Yazılardaki sayılar Dolphy'nin kendi test ortamında alınan ölçümlerden geliyor; her yazı ölçümün kapsamını ve sınırını da söylüyor.
İçerik 28 Eylül 2026 tarihinde kontrol edildi
Aynı soruları müşterilere tekrar tekrar yazmayın
Dolphy web sitesi, WhatsApp ve Instagram'da işletmenizin kendi bilgisiyle yanıt verir, talepleri panele düşürür.