İçindekiler13 başlık
Dolphy bir işletmenin web sitesini tarayıp chatbot'un bilgi tabanını kuruyor. Hat beş adımdan oluşuyor: keşif (hangi sayfalar var?), çekme, ayıklama (menü ve altbilgiden arınmış içerik), parçalama ve vektöre çevirme, yayın. Bir de düzenli yenileme var.
Bu hattı 25 sayfadan 375 sayfaya kadar farklı sitelerde çalıştırdık: bir evcil hayvan mağazası, bir elektronik mağazası, bir diş kliniği, emlak ve otel siteleri. Bulduğumuz hataların neredeyse hiçbiri hata mesajı üretmedi. Hepsi sessizce yanlış ya da eksik bilgi tabanı üretiyordu. Chatbot da bu bilgi tabanına güvenerek "bu konuda bilgim yok" diyordu.
Keşif
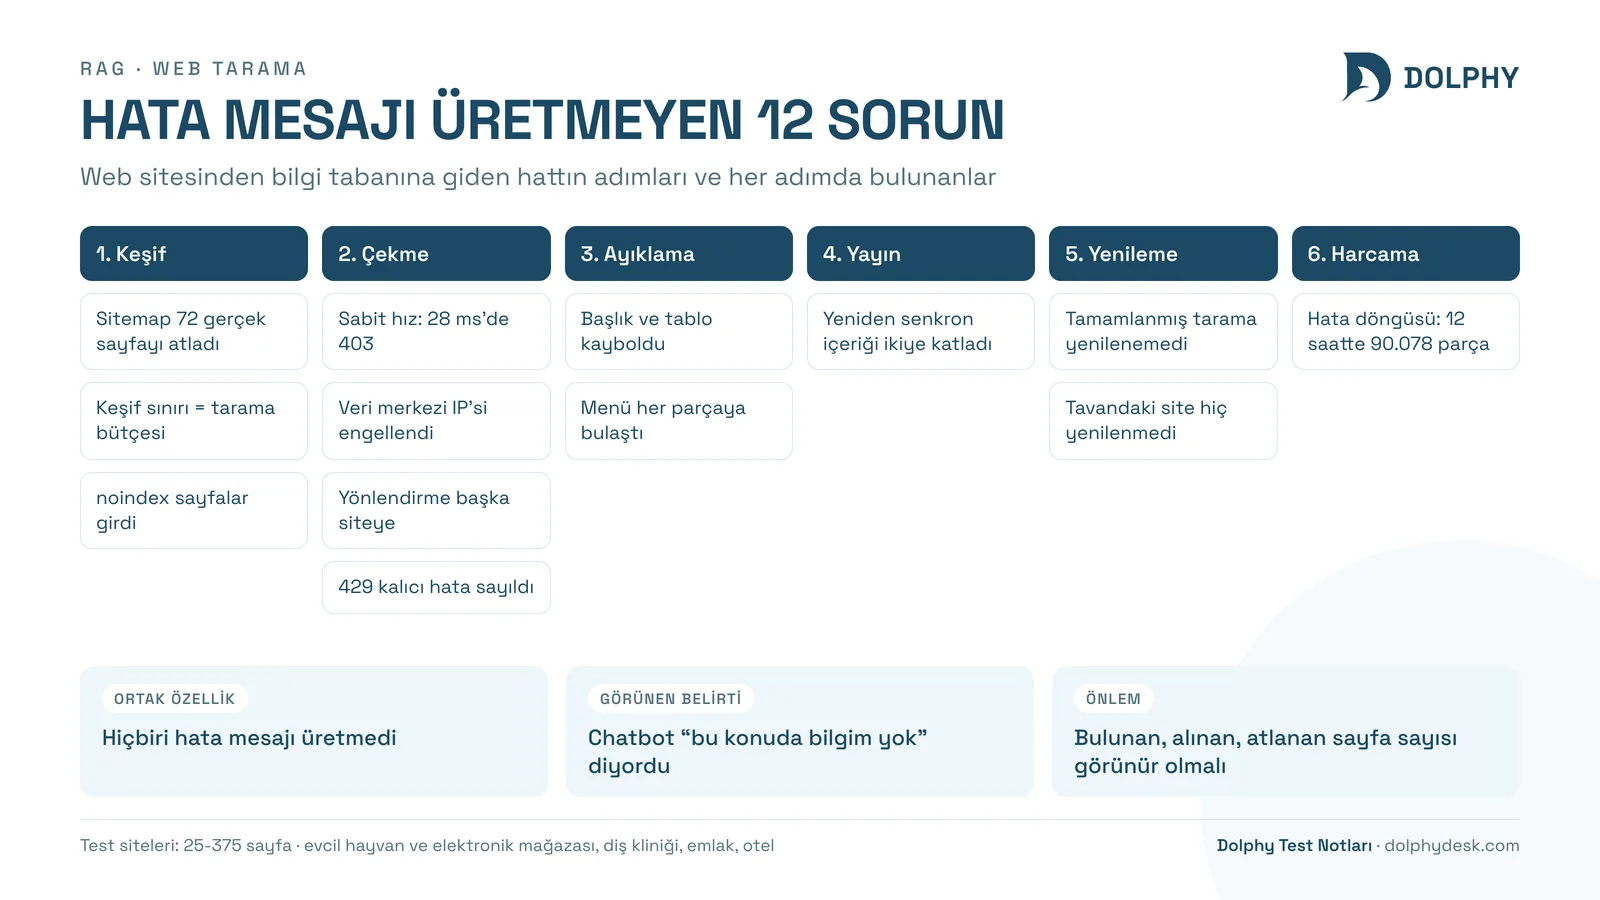
1. Sitemap her şey değil. 374 sayfalık bir e-ticaret sitesinde sitemap 263 adres veriyordu. Sayfalardaki bağlantıları izleyen keşif 112 adres daha buldu; bunların 72'si sitemap'in kaçırdığı gerçek sayfalardı (49 kategori, 24 marka sayfası). Google'ın kendi rehberi de sitemap'i yalnız bir keşif ipucu olarak tanımlıyor.
2. Keşif sınırı ile tarama bütçesi aynı sayıydı. 40 sayfalık bir tarama bütçesi, sitemap'in yalnız ilk 40 adresini görmek demekti; hangi sayfaların alınacağı sitemap'in sırasına kalıyordu. Keşif artık bütçenin dört katına kadar adres görüyor, bütçe bunlardan hangilerinin alınacağına karar veriyor.
3. Dizine kapalı sayfalar bilgi tabanına giriyordu. Sesli asistan "Fiyatlar" sorusunda bir WhatsApp yönlendirme sayfasının kartını gösterdi. Bu sayfa ve sahte örnek verili demo sayfaları arama motorlarına noindex ile kapalıydı ama bizim tarayıcımız bu işarete bakmıyordu. Tarayıcı artık sayfa içi noindexe uyuyor; Dolphy'nin kendi sitesinde 21 sayfa atlandı ve 55 parça silindi.
Çekme
4. Sabit hız IP engeli getirdi. Aynı anda 4 sayfa çekmeyi denediğimizde bir site 28 milisaniyede HTTP 403 döndü: güvenlik duvarı taramayı saldırı saydı. Aynı anda 1 sayfaya düşünce 40 sayfa yaklaşık 220 saniye sürdü. Sorun sayıda değil geri bildirim eksikliğindeydi. Yeni kural: 2 ile başla, temiz geçen sayfalarda 4'e aç, 403/406/429/503 görünce hemen 1'e in, Retry-After başlığına ve robots.txt'teki Crawl-delaye uy. Aynı 40 sayfa 119-121 saniyede, sıfır engelle alındı.
5. Veri merkezi IP'leri engellenebiliyor. Bir sitede sunucumuzdan yapılan 50 isteğin 50'si 403 aldı; aynı adresler başka bir bağlantıdan sorunsuz açılıyordu. Site veri merkezlerinden gelen trafiği topluca engelliyordu. Çözüm teknik değil operasyonel: işletme sunucunun IP'sini beyaz listeye alıyor ya da tarama bir vekil sunucu üzerinden yapılıyor. Bu sitede kurulum sırasında bunu sormak gerekiyor.
6. Bir yönlendirme başka bir siteye gitti. Evcil hayvan mağazasındaki /auth/google adresi Google'a yönleniyordu. Tarayıcı yönlendirmeyi izledi ve Google Kullanım Şartları'nın tam metni mağazanın bilgi tabanına girdi. Misafir "kargo ne kadar?" diye sorduğunda arama havuzunda Google'ın hukuk metni duruyordu. Bu bir güvenlik değil kapsam sorunuydu: Google meşru bir adres, ama o sitenin sayfası değil. Aynı dönemde eleme listesinin Türkçe adresleri tanımadığını da gördük: /giris, /kayit gibi giriş formları içerik sanılıyordu. Taramada başka bir siteye giden yönlendirme artık dışarıda bırakılıyor; eleme listesi Türkçe adresleri de tanıyor.
7. "Çok fazla istek" kalıcı hata sayılıyordu. Hata sınıflandırması "HTTP 4" ile başlayan her kodu kalıcı sayıyordu; 429 (çok fazla istek) de buna dahildi. Hız sınırına takılan tarama ilk denemede ölüyordu. Artık durum kodu okunuyor; 408 ve 429 geçici.
Ayıklama
8. Başlıklar ve tablolar kayboluyordu. İçerik ayıklayıcı sayfanın düz metnini döndürüyordu. "Fiyatlar" başlığının altındaki "Tek kişilik 1.200 TL" satırı, neyin fiyatı olduğunu söylemeyen bağlamsız bir parçaya dönüşüyordu. Çözüm iki adımdı: HTML sade Markdown'a çevriliyor (başlık, liste ve tablo korunuyor) ve her parçanın başına "Kaynak > H1 > H2" başlık yolu yazılıyor. Bu, Anthropic'in bağlamlı arama (Contextual Retrieval) fikrinin model çağrısı gerektirmeyen karşılığı: bağlamı üretmiyoruz, belgede zaten yazan yerden alıyoruz. Uzun tablo bölünürken başlık satırı her parçada tekrarlanıyor.
9. Menü ve altbilgi her parçaya bulaşıyordu. Tek bir sayfaya bakan ayıklayıcı, sitenin her sayfasında tekrar eden menüyü içerikten ayıramıyor. Kural istatistiksel: sayfaların yarısından fazlasında birebir geçen kısa satırlar (200 karakter altı) atılıyor. Kelime listesi ya da dil varsayımı yok, yalnız frekans. Kuralın ilk hâli "satırların %60'ından fazlası düşüyorsa iptal" diyordu; test bunu yakaladı: gerçek bir sayfanın yarıdan fazlası zaten şablon olduğu için kural tam işe yarayacağı yerde kendini kapatıyordu. İptal ölçütü artık oran değil kalan metin.
Tersi de oldu. Bir klinik sitesinde ayıklayıcının attığı gövde metnini ölçtük: sayfaya özgü metnin %1,81'i kayıptı ve kayıp, hizmet sayfalarındaki uyarı kutularında toplanıyordu ("Dört implant her hasta için otomatik olarak yeterli değildir"). Bu kutuları geri getiren kural ilk hâliyle 54 bin karakter ekledi; bunun 40 bini 17-38 sayfada aynen tekrarlanan yazar biyografisi ve genel uyarıydı. Tekrar kuralı kurtarılan bloklara da uygulanınca kayıp %0 oldu ve yalnız 12,6 bin karakter eklendi.
Ayıklama için açık kaynak ayıklayıcıları karşılaştıran güncel bir ölçüm (WCXB, 2.008 sayfa) iyi bir teşhis verdi: makale sayfası çözülmüş bir problem (en iyi sistem 0,93), ürün (0,641), liste (0,710) ve koleksiyon (0,716) sayfaları değil. Liste sayfasında ayıklayıcılar çoğu zaman listenin tamamı yerine tek bir kartı alıyor. Tekrar eden kart bloklarını ve gizli sekmeleri HTML'den geri getiren bir adım ekledik. Ölçerken bir yanılgıyı da yakaladık: bir ilan sayfasındaki ilk "kazanç" (1.290 karakterden 2.503'e) gerçekte tekrardı; ayıklayıcı içeriği zaten almıştı.
Yayın ve yeniden senkron
10. Yeniden senkron bilgi tabanını ikiye katlıyordu. Bir kaynağı yeniden senkronlamak yeni parçaları ekliyor ama eskileri silmiyordu. Semptom "cevap tekrar ediyor" değildi. Aynı metnin kopyaları ilk 8 sonucu işgal ediyor, başka kaynaklardaki bilgiyi listeden itiyordu; kopyalar da promptta tekilleştirildiği için görünmüyordu. Görünen tek şey "başka kaynaktaki bilgi hiç gelmiyor" oldu. Yeniden kurulum artık önce siliyor, sonra yazıyor; değişmeyen içerik bir parmak iziyle tanınıyor ve yeniden vektöre çevrilmiyor.
11. Yenileme bazen hiç çalışmıyordu. İki ayrı durumda gördük. Birincisinde yenileme işi yalnız bekleyen sayfaları işliyordu; hepsi tamamlanmış bir taramada hiç sayfa işlemiyor ve kaynağı "İçerik bulunamadı" diye hataya düşürüyordu. İkincisinde sayfa tavanına ulaşan tarama "duraklatılmış" sayılıyordu ve otomatik yenileme duraklatılmış bütün kaynakları atlıyordu. Tavanı aşan bir sitenin fiyatları ve yeni sayfaları haftalık yenilemede hiç güncellenmeyecekti. İlgili testler geçiyordu, çünkü iki kuralın birleşimini sınamıyordu; sorun kod okunarak bulundu. Tavan duraklaması artık yenileniyor; bütçe duraklaması yenilenmiyor.
Harcama
12. Hata döngüsü para yakıyordu. Bir gece tarama işleri yayın adımında düşmeye başladı: çift kayıt, veritabanı zaman aşımı ve sağlayıcı kotası. Her iş üç kez yeniden denendi ve her denemede aynı sayfalar yeniden vektöre çevrildi. 12 saatte 90.078 parça gömüldü; fatura 319 TL tuttu ve ara tabloya yazılan vektörler sunucunun diskini doldurdu. Hiçbir katman "bugün ne kadar harcadık?" ya da "art arda kaç iş düştü?" sorusunu sormuyordu.
Artık bir harcama sigortası var:
- Günlük tavan: tarama ve embedding için işletme başına 3, toplam 8 dolar. İş başında, her embedding partisinde ve her yapay zekâ düzenlemesinde kontrol ediliyor.
- Sağlayıcı sigortası: kredi bitti hatasında 60 dakika, art arda iki kota hatasında ya da 30 dakikada 8 düşen işte 30 dakika yeni tarama alınmıyor.
- Alarm: duraklatma, sigortanın açılması ve günlük harcamanın 5 doları geçmesi e-postayla bildiriliyor.
Sigorta kısa süre sonra başka bir döngüyü yakaladı: bir sitenin SSL sertifikasının süresi dolmuştu, her yenileme denemesi düşüyor, kaynak hep "vadesi gelmiş" kaldığı için birkaç dakikada bir yeni iş açılıyordu. İş çekme adımında düştüğü için para harcanmadı ama alarm sürekli çalıştı. Hata veren kaynak artık 24 saat otomatik yenilenmiyor.
Ölçerken düştüğümüz tuzaklar
- Çalışan süreç eski kodu koşuyordu. Sayfa tavanını yükselttik, işçi eski değeri kullanmaya devam etti; ayar modül yüklenirken okunuyordu.
- Birden çok yerel işçi aynı anda koştu ve bir ölçümü tamamen karıştırdı.
- Ölçüm aracı üretim yolunu kopyalıyordu, çağırmıyordu. Değerlendirme aracı üretimde açık olan bir adımı atlıyordu; bütün ölçümler yanlış hattı ölçmüştü.
- Kendi hızımızı yanlış ölçtük. "Tarama 30 dakika sürer" hesabı, işçinin durdurulmuş olduğu bir pencerede yapılmıştı; gerçek süre yaklaşık 3 dakikaydı.
Kendi hattınızda nasıl önlersiniz?
- Sessiz hatayı arayın. Bilgi tabanı hattında hataların çoğu mesaj üretmez. Kaynak başına bulunan, alınan, atlanan ve boş dönen sayfa sayılarını görünür yapın.
- Tarama hızını geri bildirime bağlayın. Sabit eşzamanlılık ya yavaştır ya engel yer.
- Yönlendirmelerin alan adını kontrol edin. Başka bir siteye giden yönlendirme bilgi tabanına yabancı içerik sokar.
- Menüyü istatistikle ayıklayın, iptal kuralını test edin. Oran tabanlı güvenlik kuralı tam gerektiği yerde kendini kapatabilir.
- Yeniden senkronda önce silin. Kopyalar arama sonuçlarını işgal eder ama görünmez.
- Harcamaya tavan ve devre kesici koyun. Yeniden deneme döngüsü, her denemede aynı işi yeniden ödetir.
Ölçümün sınırları
Hatalar belirli sitelerde ve belirli dönemlerde bulundu; başka platformlarda (JavaScript ile çizilen siteler, taranmış PDF'ler) farklı sorunlar çıkabilir. Maliyet rakamları o dönemin model ve embedding fiyatlarıyla hesaplandı.
Sık sorulan sorular
Bu bölümdeki sorular, aynı konuda en sık arananlardan derlendi.
01Chatbot için sitenin tamamını taramak gerekir mi?
Genellikle hayır, ama önemli sayfaların taranmış olması gerekir: fiyat, hizmet, iletişim, iade ve kargo. Sitemap bunların bir kısmını atlayabilir; bağlantı keşfi ve kurulumda önemli sayfaların tek tek kontrolü önerilir.
03Site taramasında 403 hatası neden alınır?
İki yaygın sebep var: çok hızlı istek (güvenlik duvarı taramayı saldırı sanar) ve veri merkezi IP'lerinin toplu engellenmesi. İlki geri bildirimli hızla çözülür. İkincisi için işletmenin sunucu IP'sini beyaz listeye alması ya da bir vekil sunucu gerekir.
04Bilgi tabanı yenilemesi ne sıklıkla yapılmalı?
İçeriğin ne sıklıkla değiştiğine bağlı. Dolphy'de varsayılan yenileme haftalık. Önemli olan yenilemenin gerçekten çalıştığını ölçmek: bizim durumumuzda tavanı aşan sitelerde yenileme bir süre hiç çalışmıyordu ve hiçbir test bunu göstermiyordu.
Mustafa Gürbüz
Dolphy Yöneticisi
Dolphy'nin yöneticisi. Sesli asistan, yazılı sohbet ve bilgi tabanı hattındaki testleri yürütüyor. Yazılardaki sayılar Dolphy'nin kendi test ortamında alınan ölçümlerden geliyor; her yazı ölçümün kapsamını ve sınırını da söylüyor.
İçerik 28 Eylül 2026 tarihinde kontrol edildi
Aynı soruları müşterilere tekrar tekrar yazmayın
Dolphy web sitesi, WhatsApp ve Instagram'da işletmenizin kendi bilgisiyle yanıt verir, talepleri panele düşürür.