İçindekiler13 başlık
Sesli asistanın bir cümleyi yanlış duyması çoğu zaman sorun olmaz; bağlamdan ne kastedildiği anlaşılır. Bir adı, telefon numarasını ya da e-posta adresini yanlış duyması ise talebin yanlış kişiye, yanlış numaraya kaydedilmesi demek.
Bu yazının tetikleyicisi gerçek bir görüşmeydi. Arayan kişi demo talebi bırakırken adını birkaç kez söyledi; konuşma tanıma adı her seferinde farklı yazdı ve kişi görüşmeyi kapattı. Kelime güveni o görüşmede medyan 0,33-0,48 arasındaydı. Sorunun o kişiye özgü olmadığını görünce Türkçe konuşma tanımayı (STT) ayrı bir ölçüm konusu yaptık.
Önce bağımsız bir karşılaştırma aradık
Bulamadık. Ticari STT modellerini karşılaştıran bilinen listelerin (Artificial Analysis, Hugging Face Open ASR, Pipecat stt-benchmark) hiçbiri Türkçe ölçmüyor. Bulabildiklerimiz ya açık modellerle sınırlı (Whisper large-v3-turbo, Common Voice 17'de %10,1 kelime hatası) ya da eski (2021 tarihli MediaSpeech: Azure %23, Google %27).
Sağlayıcıların kendi iddiaları var ama birbiriyle kıyaslanamıyor: her biri farklı veri setinde birinci. ElevenLabs Scribe v1 (toplu) için FLEURS'ta %3,1, Soniox kendi YouTube setinde Türkçe %8,9 yazıyor. Hiçbiri gürültüde söz uydurmayı ölçmüyor. FLEURS temiz, okunmuş ses.
Sonuç: karar için kendi setimizi kurduk.
Ölçüm düzeneği
- Set: 44 sentetik Türkçe cümle. Kategoriler: tek ad, ad-soyad, firma adı, telefon, e-posta, tarih, kısa cevap, harf harf heceleme, uzun cümle. Setteki ad, firma ve numaralar uydurma; gerçek kişi verisi yok.
- Sesler: 4 Cartesia sesi ve macOS'un Türkçe sesi.
- Koşullar: temiz, telefon hattı (8 kHz μ-law) ve ofis gürültüsü (~10 dB SNR). Ayrıca yalnız gürültü içeren klipler ve bizim ekibin gerçek kayıtları.
- Canlı koşul: akış modelleri canlıdaki gibi gerçek zaman hızında ve bizim sessizlik algılamamızla kesinleştirilerek koşuldu.
- Puan: genel kelime hatası (WER) yanında varlık doğruluğu. Ad ve firma tam kelime, telefon rakam dizisi, e-posta yazılı biçim olarak eşleşmeli. Yalnız gürültü klibinde yazı çıkarsa "uydurma" sayıldı.
İlk tur: Scribe ve toplu modeller
Üç koşulun birlikte sonucu (670 klip):
| Ayar | Ad | Ad-soyad | Firma | E-posta | Telefon | Gürültüde uydurmadı | Bekleme p50 |
|---|---|---|---|---|---|---|---|
| Scribe v2 Realtime, TR+EN | %72 | %83 | %64 | %13 | %100 | %80 | 250 ms |
| Scribe v2 Realtime, yalnız TR | %73 | %83 | %64 | %13 | %100 | %80 | 249 ms |
| Scribe v2 toplu | %57 | %92 | %79 | %60 | %100 | %0 | ~600 ms |
| OpenAI gpt-4o-transcribe, toplu + soru bağlamı | %85 | %79 | %83 | %47 | %92 | %0 | 771 ms |
| OpenAI gpt-transcribe, toplu + soru bağlamı | %86 | %89 | %83 | %67 | %98 | %100 | 704 ms |
"Soru bağlamı", asistanın son sorusunun ("Adınızı öğrenebilir miyim?") modele ipucu olarak verilmesi. Ad ve e-posta sorularında belirgin fark yaratıyor.
Scribe'ın tipik hataları Türkçe özel adlarda toplanıyordu: "Çağrı" → "Çarşamba", "Şükrü" → "Şükür", "Hüseyin" → "Hussein". "Ya hiç gerek yok, sonra ararım" cümlesi üç seste boş döndü. İki modelin aynı seste yaptığı ortak hatalar ("Nurcan" → "Murcan", "Tuğba" → "Tuba") büyük olasılıkla sentetik sesin telaffuzundan kaynaklanıyordu; bu, sentetik setin iyimser olduğunu hatırlatıyor.
Toplu modellerin doğruluğu cazipti. Ama ses bittikten 0,6-0,8 saniye, bazı ayarlarda 1-5 saniye sonra sonuç veriyorlardı. Canlı konuşmada "0,25 saniye nerede, 1,6 saniye nerede" sorusunun cevabı açıktı.
İkinci tur: Gemini 3.5 Transcribe Live
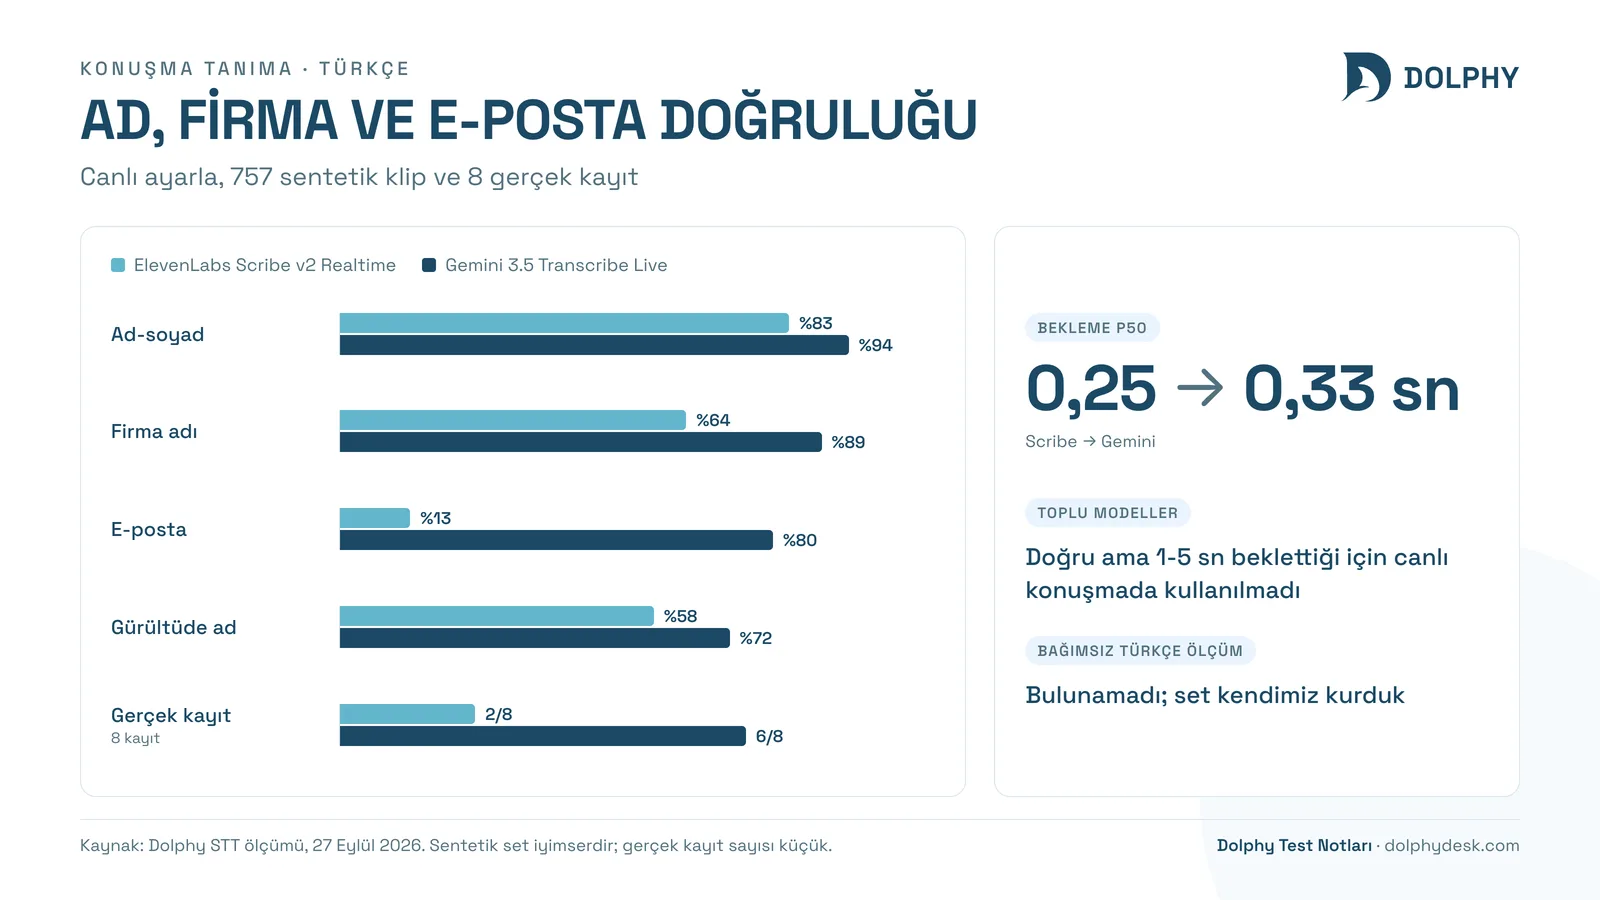
Aynı sete sonradan yayımlanan Gemini 3.5 Transcribe Live eklendi. Akış modeli olduğu için canlı konuşmaya uygundu. 757 sentetik klip ve ekibin 8 gerçek kaydıyla:
| Scribe v2 Realtime | Gemini 3.5 Transcribe Live | |
|---|---|---|
| Ad-soyad | %83 | %94 |
| Firma | %64 | %89 |
| E-posta | %13 | %80 |
| Gürültüde ad | %58 | %72 |
| Gerçek kayıt (8) | 2/8 | 6/8 |
| Bekleme p50 | 0,25 sn | 0,33 sn |
| Dakika fiyatı | ~$0,0065 | ~$0,009 |
Canlı hattı Gemini'ye taşıdık. Dönüş tek ayarla yapılabiliyor. Geçerken üç ayar ölçümle belirlendi:
- Dil listesi yalnız görüşmenin dili olmalı. Türkçe + İngilizce birlikte verilince tek adda %67, yalnız Türkçe verilince %81 çıktı. Misafir dil değiştirirse akış bir sonraki cümleden önce yeni dille yeniden bağlanıyor.
- "Söyleneni aynen yaz" modu kaldı. Düzeltme yapan mod "0532 pardon 0533" gibi cümleleri güzel çözüyordu ama bir kez gürültülü bir adı alakasız bir kelimeye çevirdi. Sonuçlar başa baştı, aynen yazan mod seçildi.
- İşletme sözlüğü verilmedi. Sözlükteki terimler ara yazılara sızdı ve doğru adı bozdu.
Bir teknik ayrıntı da kayda değer: modelin kendi etkinlik algılamasını kapattık, konuşmanın başını ve sonunu kendi sessizlik algılayıcımız belirliyor. Etkinlik dışındaki ses modele hiç gönderilmiyor; gönderilince model onu atmıyor, sonraki cümleye ekliyordu.
Bilinen eksikler de var: Gemini kelime güveni döndürmüyor ve 750 konuşma klibinin 3'ünde, gürültüde söylenen tek kelimelik ad boş döndü.
Denediğimiz diğer sağlayıcılar
- AssemblyAI: Ekibin kayıtlarıyla yapılan küçük denemede konuşmalarda kelime hatası Scribe'dan düşüktü (%7'ye %12). Ama yalnız gürültü içeren kayıtta (öksürük, masaya vurma) her gürültü patlamasına bir "Evet" yazdı. Bu uydurmaların güveni 0,71-0,99 arasındaydı, yani güven eşiğiyle süzülemiyordu. Sesli asistanda "Evet" onay kelimesi olduğu için bu davranış talebi yanlışlıkla onaylatabilir. Gürültü ayarlarını sıkılaştırınca uydurma azaldı ama konuşma bozuldu ("bu ürün için" → "buyrun").
- Soniox: Kâğıt üzerinde en ucuz Türkçe akış modeliydi. Hesap test edilmeden önce bakiye istedi; denemedik.
- Freya: Türkiye odaklı bir sağlayıcının STT'si 4 kliplik küçük denemede en düşük hatayı verdi (%3). Klip tek parça gönderildiği için sonuç onun lehine eğikti; akış ucu beta ve özel sözlük almıyordu.
Ölçerken düştüğümüz tuzaklar
Bu bölüm belki yazının en faydalı kısmı. Sayılar ancak bu tuzaklar kapatıldıktan sonra anlam kazandı.
- Etiketsiz klipte %100 başarı. Gerçek kayıtlarda varlık etiketi boştu. "Bütün varlıklar bulundu mu?" kontrolü boş listede her zaman doğru döner; ad tamamen yanlış yazılsa bile sonuç %100 görünüyordu.
- Kapsama farkı. Aynı tabloda bir ayar 670 klibin 670'inde, bir başkası 656'sında, bir sağlayıcı yalnız 4'ünde koşmuştu. Yüzdeleri yan yana koymadan önce ölçülen/toplam oranını göstermek gerekiyor.
- Makro ve korpus WER. Tek kelimelik bir klipte 1 hata ile dokuz kelimelik bir klipte 0 hata varsa klip ortalaması %50, toplam kelime hatası %10 olur. İkisi farklı soruların cevabı.
- Alt dize eşleşmesi. Beklenen numara 10 hane, çıktı fazladan bir rakamla 11 hane olsa da "numara içinde geçiyor" kontrolü geçiyordu.
- Bağımsız sanılan örnekler. 660 sentetik klip aslında 44 cümlenin ses ve koşul varyantı. Güven aralığı hesaplanacaksa cümle düzeyinde gruplamak gerekiyor. Dört bağımsız örneğin dördü geçse bile %95 güvenle alt sınır yaklaşık %51'dir.
- Önbellek. Sonuç önbelleği yalnız dosya yolunu anahtar yapıyordu; ses ya da ayar değişse eski sonuç yeni deney gibi okunabilirdi.
Kendi ölçümünüzü kurarken
- İşinize yarayan bilgiyi ölçün. Sesli asistan için genel WER yetmez; ad, telefon, e-posta ayrı sayılmalı.
- Gürültüde söz uydurmayı ayrı ölçün. Onay kelimesi uyduran bir model, doğruluğu yüksek olsa da tehlikeli.
- Canlı koşulu taklit edin. Akış modelini gerçek zaman hızında, kendi kesinleştirme kuralınızla koşun; toplu sonuçla karşılaştırmayın.
- Sentetik set iyimserdir. Mümkün olan en erken aşamada gerçek, izinli kayıtlar ekleyin.
- STT hatasını seslendirme hatasından ayırın. Kayıtta ses doğru ama yazı yanlışsa STT; yazı doğru ama söylenen yanlışsa seslendirme.
Ölçümün sınırları
Sentetik set 44 cümleden türetildi ve 5 sesle üretildi; gerçek konuşmacı çeşitliliğini temsil etmez. Gerçek kayıt sayısı 8. Bu yüzden tablodaki farklar yön gösterir, genel bir sağlayıcı sıralaması değildir. Freya ve AssemblyAI denemeleri birkaç klipten ibaret. Fiyatlar ölçüm tarihindeki liste fiyatları.
Sık sorulan sorular
Bu bölümdeki sorular, aynı konuda en sık arananlardan derlendi.
01Türkçe için en iyi konuşma tanıma modeli hangisi?
Bağımsız bir Türkçe karşılaştırma yok, bu yüzden genel bir "en iyi" demek zor. Bizim canlı konuşma setimizde Gemini 3.5 Transcribe Live ad, firma ve e-postada öne çıktı. Toplu (dosya) modeller de doğruydu ama canlı konuşma için fazla bekletti. Kendi senaryonuzla, kendi seslerinizle ölçmenizi öneririz.
02Özel sözlük (keyterm) vermek adları düzeltir mi?
Kısmen. Sözlük işletme adı ve ürün adları için işe yarayabilir ama arayanın adını önceden bilemezsiniz. Bizim denememizde sözlük bir modelde ara yazılara sızıp doğru adı bozdu. Ad için daha güvenilir yol, adı sesli olarak geri okuyup doğrulatmak.
03Gürültü azaltma STT doğruluğunu artırır mı?
Bizim ölçümümüzde artırmadı, düşürdü. RNNoise ve DeepFilterNet gürültülü klipte doğruluğu %76'dan %58 ve %62'ye indirdi. Ayrıntılar gürültü temizleme yazısında.
04Toplu (batch) model neden canlı konuşmada kullanılmıyor?
Toplu model sesin tamamını bekler ve sonucu ses bittikten sonra verir. Bizim ölçümümüzde bu 0,6 ile birkaç saniye arasında ek bekleme demekti. Akış modeli ise konuşurken yazar ve 0,25-0,35 saniyede kesin sonuç verebilir.
Mustafa Gürbüz
Dolphy Yöneticisi
Dolphy'nin yöneticisi. Sesli asistan, yazılı sohbet ve bilgi tabanı hattındaki testleri yürütüyor. Yazılardaki sayılar Dolphy'nin kendi test ortamında alınan ölçümlerden geliyor; her yazı ölçümün kapsamını ve sınırını da söylüyor.
İçerik 28 Eylül 2026 tarihinde kontrol edildi
Aynı soruları müşterilere tekrar tekrar yazmayın
Dolphy web sitesi, WhatsApp ve Instagram'da işletmenizin kendi bilgisiyle yanıt verir, talepleri panele düşürür.