İçindekiler13 başlık
Bir randevu asistanının en sık söylediği şeyler sayılardır: saat, tarih, fiyat, telefon numarası, kat, oda numarası. Bir sayıyı yanlış okuyan asistan, cevabı doğru bilse bile yanlış bilgi vermiş olur. "Randevunuz on dörtte" yerine "Randevunuz bir dört sıfır sıfır" demek misafiri tereddüde düşürür.
Dolphy'nin sesli hattını Cartesia'ya taşıdığımızda Türkçe sayı okumasını ayrı bir test konusu yaptık. Bu yazıda nerede bozulduğunu, çözümü neden modele bırakmadığımızı ve çeviriciyi nasıl doğruladığımızı anlatıyoruz.
Nerede bozuluyordu?
Test görüşmelerinde ve yan yana dinlemelerde gördüğümüz örnekler:
- Saat rakam rakam: "14:00" → "bir dört sıfır sıfır". Ek de ayrı okunuyordu: "on dört 'te".
- Telefon rakam rakam: On bir haneli numara tek tek rakamlarla, nefessiz okunuyordu.
- Sıra sayısı cümle sonu: "3. kat" noktadan bölünüp "üç. kat" gibi okunuyordu.
- Tarih: "28/09/2026" eğik çizgilerden bozuluyordu.
- "hatta" kelimesi: "Hatta kalın" cümlesinde "hatta" bağlaç gibi okundu. Metni "hattan ayrılmayın" olarak değiştirdik.
Cartesia'nın belgesi tarih, saat ve telefonun doğru okunduğunu söylüyor. Türkçe testlerimizde bu her zaman tutmadı. Sağlayıcının kendi normalleştirmesini kapatma seçeneği belgede var ama kullandığımız LiveKit eklentisinde yok.
İlk çözüm neden işe yaramadı?
İlk akla gelen, cevap modeline "sayıları konuşma dilinde yaz" demekti. Model "on dörtte" diye yazarsa seslendirme doğru okur. Bunu bir süre kullandık ve üç sorun çıktı:
- Döküm okunmuyordu. Panelde görüşme kaydı "saat on dörtte, iki bin beş yüz liraya" gibi uzun yazılarla doluyordu.
- Uydurma sayı denetimi kör kaldı. Cevaptaki bir sayının bilgi tabanında geçip geçmediğini kontrol eden ölçümümüz rakam arıyordu. Yazıyla yazılmış sayıları göremiyordu.
- Model rakamları karıştırabiliyordu. Sayıyı kelimeye çevirmek modele gereksiz bir iş yüklüyordu.
İş bölümünü değiştirdik: cevap modeli sayıyı rakamla ve kesmeli ekle yazıyor ("14:00'te", "15 Ekim'de", "5'e"). Okunuşu ses işçisinde çalışan kurallı bir Türkçe çevirici üretiyor. Aynı metin dökümde rakamla kalıyor.
Bir ayrıntı: saat iki nokta üst üsteyle, tarih ay adıyla yazdırılıyor. "15.10" saat mi tarih mi, "24.10 TL" fiyat mı tarih mi belirsizdi.
Çevirici ne yapıyor?
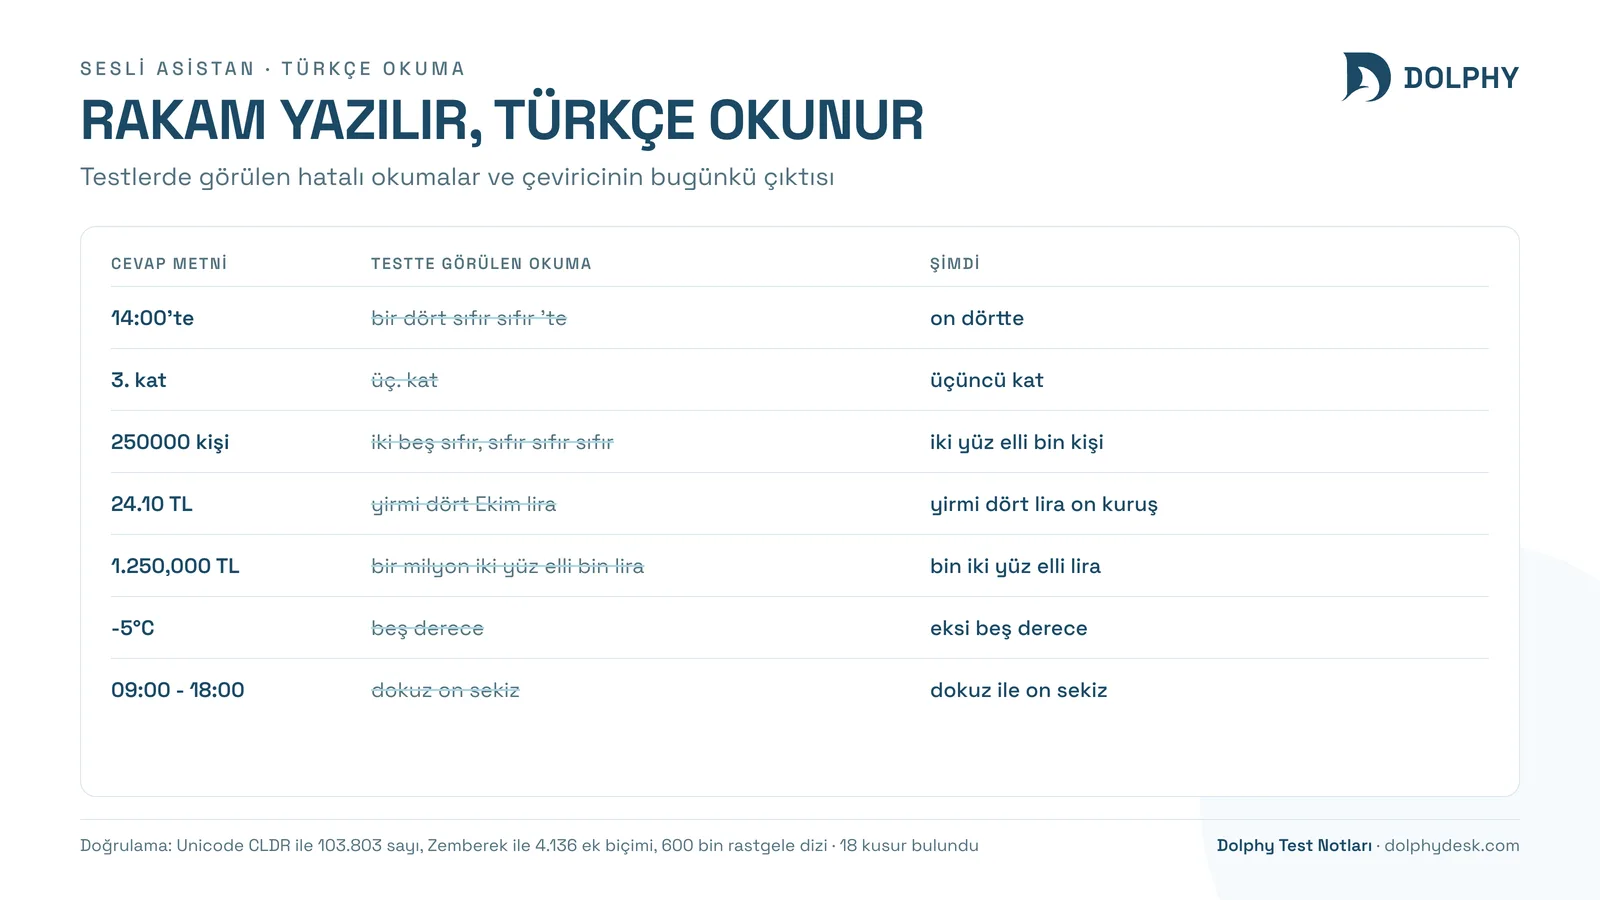
Aşağıdaki satırlar yazının hazırlanırken çeviricinin gerçek çıktısından alındı:
| Cevap modelinin yazdığı | Seslendirilen |
|---|---|
| Randevunuz 14:00'te. | Randevunuz on dörtte. |
| Ofisimiz 3. katta. | Ofisimiz üçüncü katta. |
| Kapasite 250000 kişi. | Kapasite iki yüz elli bin kişi. |
| Fiyatı 24.10 TL. | Fiyatı yirmi dört lira on kuruş. |
| Toplam 1.250,000 TL. | Toplam bin iki yüz elli lira. |
| Dışarısı -5°C. | Dışarısı eksi beş derece. |
| 2.500 TL'ye kadar. | iki bin beş yüz liraya kadar. |
| Randevunuz 5'e ertelendi. | Randevunuz beşe ertelendi. |
| %20 indirim. | yüzde yirmi indirim. |
| Numaramız 0512 345 67 89. | Numaramız sıfır beş yüz on iki, üç yüz kırk beş, altmış yedi, seksen dokuz. |
| Sipariş kodunuz 482915. | Sipariş kodunuz dört sekiz iki, dokuz bir beş. |
| KVKK'ye uygun, WhatsApp'dan yazabilirsiniz. | Ka Ve Ka Ka'ya uygun, Vatsap'tan yazabilirsiniz. |
Kesmeli ek okunuşa uyuyor. "KVKK'ye" yazımı harflere göre, okunuşu "Ka Ve Ka Ka" olduğu için ek "ya"ya dönüyor. Ünlü uyumu, d/t benzeşmesi ve kaynaştırma harfi ("5'e" → "beşe") kurallarla çözülüyor. Kurallar yalnız Türkçe görüşmede çalışıyor; İngilizce görüşmede "+" işareti "artı" okunmuyor.
Neden hazır kütüphane kullanmadık?
Önce aradık. Türkçe için TypeScript'te hazır ve eksiksiz bir çözüm bulamadık:
- n2words: Sayıları doğru okuyor ama sıra sayısında hatalı ("binikiyüzelliinci" gibi bitişik ve yanlış ekli çıktılar).
- NVIDIA NeMo metin normalleştirme: Türkçe yok.
- VNLP: Türkçe odaklı ama AGPL lisanslı.
Kendi çeviricimizi yazdık ve doğrulamayı dışarıdaki bağımsız kaynaklara bağladık.
Doğrulama: üç bağımsız kol
Sayı sözcükleri: Unicode'un CLDR sayı kurallarıyla (unicode-rbnf) 103.803 değerde karşılaştırıldı; hepsi birebir tuttu. n2words ile kardinal sayılarda da %100 uyum çıktı.
Ekler: Zemberek'in Python sürümüyle (zeyrek) 4.136 ek biçimi çözümlendi; 3.970'i doğrulandı. Kalanlar yanlış yazılmış girdilerin "düzeltmesiydi" ve ayrıca incelendi. Bunlara 1.440 saat × 5 ek, TDK'nin kesme işareti, kısaltma ve sayı yazımı kuralları ile yaklaşık 250 gerçekçi cümle eklendi.
Dayanıklılık: 600 bin rastgele dizi üretildi. Amaç doğruluk değil, çeviricinin hiçbir girdide takılmaması, hata vermemesi ve yavaşlamamasıydı.
Doğrulama 18 kusur yakaladı. En öğreticileri:
- Fiyat 1000 kat: "1.250,000 TL" İngilizce binlik gibi okunup "bir milyon iki yüz elli bin" oluyordu. Türkçe binlik nokta varsa virgülden sonrası ondalık sayılıyor.
- Fiyat tarih oldu: "24.10 TL" → "yirmi dört Ekim lira"; "$12.30" ve "%2.49" saat gibi okunuyordu. Para, yüzde ve birim yanındaki sayı artık saat ya da tarih sayılmıyor.
- Eksi işareti düşüyordu: "-5°C" → "beş derece".
- Sonsuz döngü: 400 sıfırlı bir sayı ve ardından "+1" gelen bir girdi çeviriciyi kilitliyordu. Sayı grupları sınırlandı.
- Ek hataları: "buçuka" (doğrusu "buçuğa"), "ayın 2'inde" → "ikininde", "#1234'ü" → "dört'ü".
- Yavaşlık: e-posta okuma kuralı 50 KB'lik metinde 3,4 saniye sürüyordu; 0,8 ms'ye indi.
- Kısaltmalar: "Dr. Ayşe", "Ltd. Şti.", "2. Blok" noktada bölünüyordu.
Canlıya alındıktan sonra da iki kusur çıktı. Ayraçsız 6 haneden uzun her dizi numara sayılıyordu: "250000 kişi" → "iki beş sıfır, sıfır sıfır sıfır". "000" ile biten dizi artık miktar sayılıyor, çünkü numara ve kodlar genellikle öyle bitmiyor. İkincisi dökümde "sistemidir. . Mesajdan" gibi çift nokta çıkarıyordu; akış cümleyi noktadan bölüyor, sonraki parça bir satır sonuyla başlıyor ve satır sonu ikinci nokta oluyordu.
Son adım kulak testiydi: 20 sayılı cümle Cartesia'nın Türkçe sesiyle seslendirildi. Metin tarafında 20'de 20 doğruydu; dinleme ayrıca yapılıyor.
Kararı bekleyen küçük durumlar
Bazı okunuşlar kural değil tercih meselesi, kulak testiyle karar verilecek:
- Kesir TDK'ye göre "bir bölü iki" okunuyor; "yarım" daha doğal olabilir.
- "iOS 17.2" gibi sürüm numaraları ondalık okunuyor.
- THY, SGK gibi kısaltmalar sözlükte yok.
- Beş haneli posta kodu sayı gibi okunuyor.
Kendi hattınızda nasıl uygularsınız?
- Sayıyı modele değil kurala çevirtin. Model rakamla yazsın, okunuşu deterministik bir çevirici üretsin. Döküm okunur kalır, sayı denetimi çalışır.
- Belirsiz biçimleri kaynağında kapatın. Saati iki nokta, tarihi ay adıyla yazdırın; "15.10" gibi biçimler hem insanı hem çeviriciyi şaşırtır.
- Para, yüzde ve birimi önce yakalayın. Aksi hâlde fiyat tarih, yüzde saat olur.
- Doğrulamayı bağımsız kaynağa bağlayın. CLDR ve Zemberek gibi kaynaklar kendi testinizin göremediği hataları yakalar.
- Rastgele girdiyle kilitlenmeyi test edin. Ses işçisinde takılan bir fonksiyon bütün görüşmeyi susturur.
Ölçümün sınırları
Doğrulama çeviricinin metin çıktısını kapsıyor. Seslendirme motorunun bu metni nasıl okuduğu ayrı bir soru ve kulak testiyle bakılıyor. Kurallar Türkçe için yazıldı; diğer dillerde çalışmıyor. Gerçek konuşmalardaki sayı çeşitliliği test setindekinden geniş olabilir.
Sık sorulan sorular
Bu bölümdeki sorular, aynı konuda en sık arananlardan derlendi.
01Sesli asistan neden saati rakam rakam okur?
Seslendirme motoru "14:00" gibi bir metni saat olarak tanımazsa her karakteri ayrı okur. Bu davranış motorun dil desteğine ve metin normalleştirmesine bağlı. Bizim testlerimizde Türkçe saat ve telefon her zaman doğru okunmadı; okunuşu kendi çeviricimizle üretmeye karar verdik.
02Sayıları yazıyla yazdırmak daha kolay değil mi?
Kolay ama yan etkisi var. Görüşme dökümü okunaksız hâle geliyor ve cevaptaki sayıların bilgi tabanında geçip geçmediğini kontrol etmek zorlaşıyor. Rakamla yazıp seslendirmeden hemen önce çevirmek iki sorunu da önlüyor.
03Telefon numarası nasıl okunmalı?
Türkçede alışılan biçim gruplar hâlinde okumaktır: "sıfır beş yüz on iki, üç yüz kırk beş, altmış yedi, seksen dokuz". Tek tek rakam okumak uzun ve takip etmesi zor. Akışta bölünen numaranın bütün okunması için son rakam grupları kısa süre bekletiliyor.
04Türkçe sayı okuma için hazır kütüphane var mı?
Bizim araştırmamızda TypeScript için eksiksiz bir çözüm bulamadık. n2words sayıları doğru okuyor ama sıra sayılarında hata veriyor; NeMo'da Türkçe yok; VNLP AGPL lisanslı. Unicode CLDR kuralları doğrulama için güvenilir bir kaynak.
Mustafa Gürbüz
Dolphy Yöneticisi
Dolphy'nin yöneticisi. Sesli asistan, yazılı sohbet ve bilgi tabanı hattındaki testleri yürütüyor. Yazılardaki sayılar Dolphy'nin kendi test ortamında alınan ölçümlerden geliyor; her yazı ölçümün kapsamını ve sınırını da söylüyor.
İçerik 28 Eylül 2026 tarihinde kontrol edildi
Aynı soruları müşterilere tekrar tekrar yazmayın
Dolphy web sitesi, WhatsApp ve Instagram'da işletmenizin kendi bilgisiyle yanıt verir, talepleri panele düşürür.