İçindekiler14 başlık
Telefonda karşınızdaki kişi iki saniye susarsa bunu fark edersiniz. Dört saniye susarsa "Alo?" dersiniz. Sesli yapay zekâ asistanında da ölçüt aynı: misafir sözünü bitirdikten sonra ilk sesi ne zaman duyuyor?
Dolphy'nin sesli asistanını ilk canlıya aldığımızda bu süre bazı turlarda 4-6 saniyeydi. Kulağa ilk gelen açıklamalar belliydi: sunucu Türkiye'de, model ABD'de; ses sağlayıcısı yavaş; model büyük. Tahmin yerine her adımı ayrı ölçtük. Ölçüm, bu tahminlerin çoğunu eledi.
Bu yazı o ölçümlerin özeti. Aynı sorunu yaşayan herkesin kendi hattında tekrarlayabileceği bir yöntem olarak yazdık.
Neyi, nasıl ölçtük?
Tek bir "gecikme" sayısı işe yaramıyor. Bir sesli turu dört parçaya ayırdık:
- Tur sonu kararı (endpointing): Sistem misafirin sustuğuna ne zaman karar veriyor?
- Konuşma tanıma (ASR): Ses metne ne kadar sürede dönüyor?
- Cevap hattı: Metin geldikten sonra ilk cevap parçası ne zaman çıkıyor? Niyet sınıflandırma, bilgi tabanı araması ve cevap modeli bu kalemin içinde.
- Seslendirme (TTS): İlk metin parçasından ilk ses baytına kadar geçen süre.
Bu dönemde ses hattı ElevenLabs Agents üzerindeydi ve cevabı bizim uç (Custom LLM) üretiyordu. ElevenLabs her tur için bu dört kalemi ayrı raporluyor. Kendi tarafımızda da her adımın süresini günlüğe yazdık. Üçüncü kaynak ses kayıtlarıydı: dalga biçiminden misafirin sustuğu an ile asistanın başladığı an arasındaki gerçek sessizliği ölçtük.
Bir kullanıcının gerçek aramasında iki tur şöyle görünüyordu:
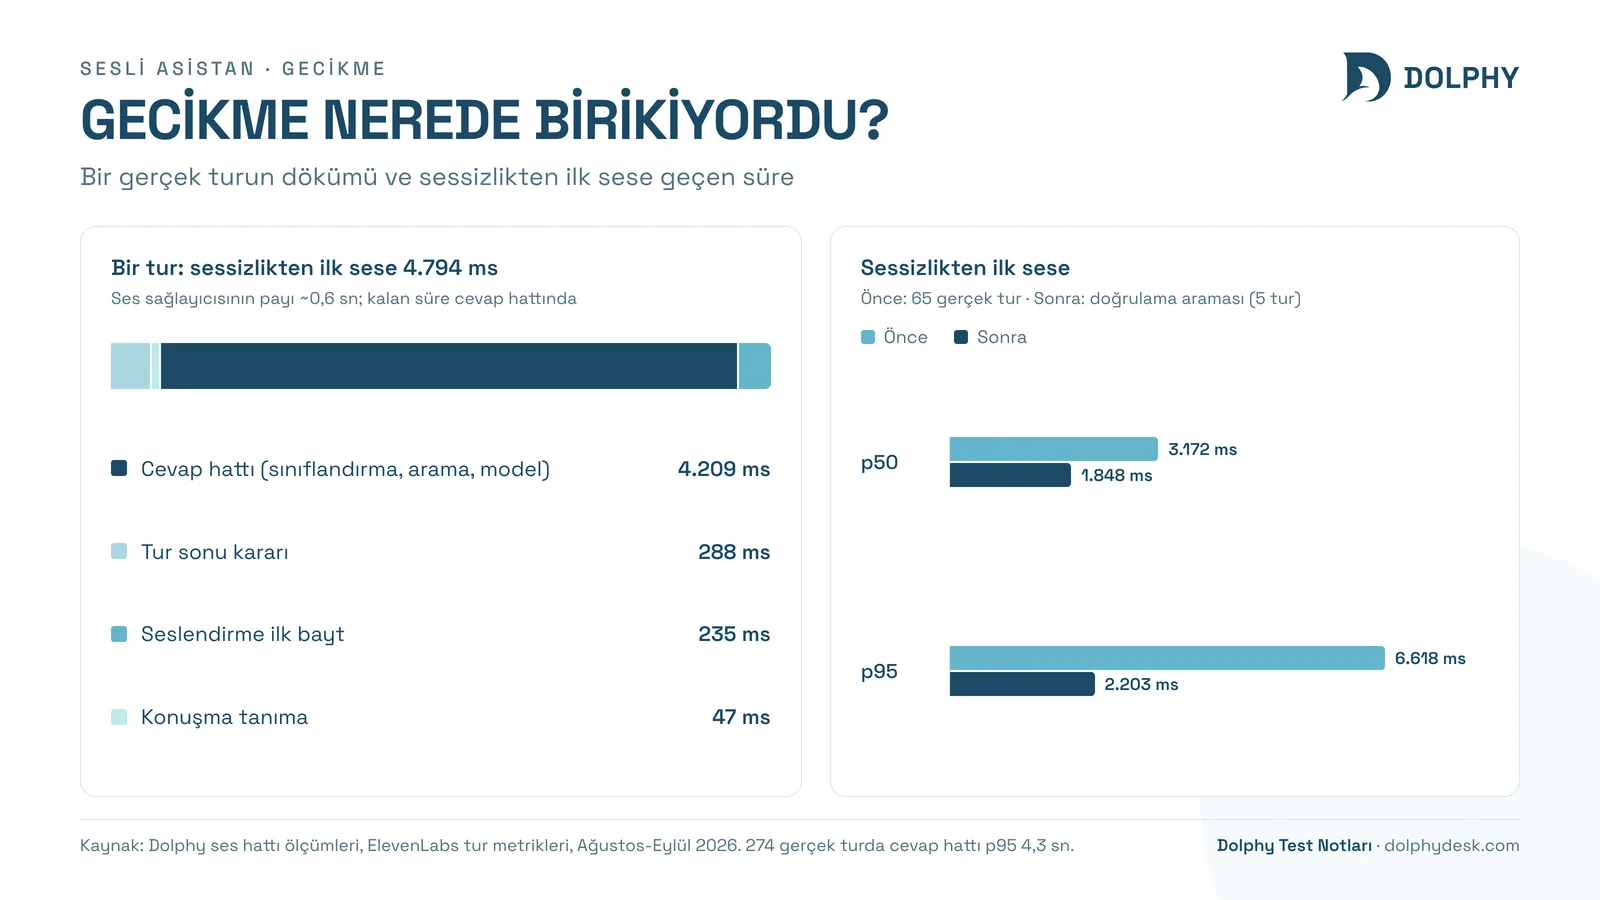
| Kalem | 1. tur | 2. tur |
|---|---|---|
| Tur sonu kararı | 288 ms | 320 ms |
| Konuşma tanıma | 47 ms | 50 ms |
| Cevap hattı (ilk bayt) | 4.209 ms | 3.168 ms |
| Seslendirme ilk bayt | 235 ms | 254 ms |
| Sessizlikten ilk sese | 4.794 ms | 3.806 ms |
Ses sağlayıcısının payı toplamda yaklaşık 0,6 saniye. Kalan her şey cevap hattındaydı.
Elenen üç tahmin
Ağ değildi. Sunucudan OpenAI'ye gidiş-dönüş 1,7 ms, TLS el sıkışması 20 ms ölçüldü. Coğrafi mesafe saniyeler eklemiyordu.
Ses sağlayıcısı değildi. Tablodaki tur sonu, tanıma ve seslendirme kalemleri birlikte 0,6 saniyenin altında kaldı.
Modeli kendi sunucumuza almak çözüm değildi. Sunucunun işlemcisi 4 çekirdek, GPU yok. 7 milyarlık bir modelin sesli promptu okuması tek başına dakikalar sürerdi. Bu seçenek hesapla elendi, denemeye gerek kalmadı.
Asıl kalem: her turda çalışan sınıflandırıcı
Her misafir cümlesi cevap modeline gitmeden önce bir sınıflandırıcıdan geçiyordu. Sınıflandırıcı niyeti belirliyor (fiyat mı, randevu mu, selamlaşma mı) ve "Peki 15 kiloluğu?" gibi eksiltili takip sorularını tam cümleye çeviriyor. Bilgi tabanı araması bu çıktıyı bekliyordu. Çağrı akışsızdı ve katı JSON istiyordu. Süresi 1.422 ile 3.412 ms arasında değişiyordu.
İki şey yaptık.
Önce sınıflandırıcının hiç çalışmaması gereken turları ayırdık. Son 500 gerçek misafir mesajını kural tabanlı ön geçişten geçirdik: mesajların %53'ü modele hiç gitmeden sınıflandırılabiliyordu. "Merhaba", "teşekkürler", "saat kaça kadar açıksınız" gibi cümleler 4 ms'de karar buluyor.
Sonra sınıflandırıcı modelini ölçerek seçtik. Aynı gerçek prompt ve şemayla, sunucudan, ısınmış bağlantıyla:
| Model | Ortalama |
|---|---|
| gpt-4o-mini | 1.365 ms |
| gpt-4.1-nano | 1.010 ms |
| gemini-2.5-flash | 766 ms |
| gemini-3.1-flash-lite | 726 ms |
| gemini-3.5-flash-lite | 703 ms |
Ortalamada en hızlısı 3.5-flash-lite görünüyordu. Birkaç gün sonra ölçüm dağılıma bakınca tablo değişti: 3.5-flash-lite 1,0 ile 3,8 saniye arasında oynuyordu, çünkü o ailede düşünme tamamen kapatılamıyor. gemini-2.5-flash ise sabit yaklaşık 1,0 saniyede kaldı. Sesli kanalda ortalama değil kuyruk önemli olduğu için 2.5-flash seçildi. Yeni sürüm her zaman daha hızlı değil; bu seri boyunca birkaç kez daha karşımıza çıkacak.
Görünmeyen ikinci kalem: embedding ve ısıtma
Bilgi tabanı araması için misafirin cümlesi önce vektöre (embedding) çevriliyor. Bu çağrı soğuk bağlantıda 869 ms, ısınmış bağlantıda 150-195 ms sürüyordu. Aramanın kendisi (veritabanı sorgusu) 35-70 ms'ydi. Yani yavaş olan arama değil, aramadan önceki çeviriydi.
Görüşme başında sağlayıcıları ısıtan bir kodumuz vardı. Ölçünce hiç çalışmadığı ortaya çıktı: ısıtma isteği tek token istiyordu, sağlayıcı bu değeri 400 hatasıyla reddediyordu ve hata sessizce yutuluyordu. Değer 16 yapılınca ısıtma çalıştı.
İkinci bir ısıtma sorunu haftalar sonra bulundu. Isıtma çağrısı uygulamanın kendi embedding önbelleğinden geçiyordu. Aynı ısıtma cümlesi önbellekte 6 saat durduğu için istek sağlayıcıya hiç ulaşmıyordu. Düzeltmeden sonra cevabın sunucuda hazır olduğu an medyan 2.660 ms'den yaklaşık 1 saniyeye indi.
Son adım kalıcı bir embedding önbelleğiydi. Aynı cümle aynı modelde her zaman aynı vektörü verir, bu yüzden bayatlama riski yoktur. Önbellek anahtarı model, boyut ve normalize edilmiş metnin özetinden oluşuyor; misafirin metni ve işletme bilgisi tabloda tutulmuyor. Sunucu yeniden başladıktan sonra aynı soru 93 ms'de cevaplandı.
Hızlandırma için başlatılan iş beklemeye dönüşebilir
Gecikmeyi azaltmanın bilinen yolu işleri paralel başlatmak. Misafirin cümlesi gelir gelmez, sınıflandırıcıyı beklemeden bilgi tabanı araması ve hatta cevap üretimi başlıyor. Karar gelince uygunsa sonuç kullanılıyor, değilse atılıyor.
İki ölçüm bu yöntemin bedelini gösterdi. Birincisi atılma oranıydı: ilk hâliyle önden yapılan arama 45 turun 30'unda çöpe gidiyordu. Karar kuralı düzeltilince kullanılabilir hâle geldi.
İkincisi daha önemliydi. Bir test aramasında önden başlatılan arama 17 saniye takıldı ve misafir 19,3 saniye sessizlik dinledi. Sebep basitti: "hızlandırmak için" başlatılan iş, sonradan cevabın zorunlu olarak beklediği bir noktaya dönüşmüştü ve süre sınırı yoktu. Embedding, önden arama ve son arama artık aynı 4 saniyelik bütçeyi paylaşıyor. Süre dolunca sağlayıcıya iptal sinyali gidiyor ve bot uydurmak yerine bilgiyi şu an kontrol edemediğini söylüyor.
Bu kuralın da bir istisnası çıktı. İşlem yapabilen (sipariş sorgulayan, stok soran) botlarda bütçe kapısı aksiyondan önce çalışıyordu. Yavaş bir embedding, aksiyon hiç çağrılmadan "sonra tekrar sorun" cevabına yol açabiliyordu. Kapı yalnız aksiyonsuz botlarda devreye girecek şekilde daraltıldı.
Ses ilk baytla değil ilk cümle bitince başlıyordu
ElevenLabs tarafındaki turları tek tek hesaplayınca bir kural daha çıktı. Ölçülen ilk ses her turda şu formülle ±30 ms tuttu: tur sonu + tanıma + cevabın ilk cümlesinin tamamlanması + seslendirme ilk baytı. Yani ilk cevap parçasının ne zaman gönderildiği değil, ilk cümlenin ne zaman bittiği belirleyiciydi.
Bu, cevap biçimini de bir hız kalemine çevirdi. Kısa bir ilk cümle ("Merhaba, fiyatlarımız şöyle.") sesi erken başlatıyor; uzun bir ilk cümle sesi o kadar geciktiriyor. Seslendirmenin kısa metni nasıl beklettiğini ayrı bir yazıda anlattık: bekleme cümlesi testleri.
Sonuç ve p95 dersi
Değişikliklerden sonra yapılan doğrulama aramasında sessizlikten ilk sese geçen süre:
| Ölçü | Önce (65 tur) | Sonra (doğrulama araması) |
|---|---|---|
| p50 | 3.172 ms | 1.848 ms |
| p95 | 6.618 ms | 2.203 ms |
Tablonun sağ sütunu tek bir aramadan geliyor. Beş turdan anlamlı bir p95 çıkmaz. Birkaç gün sonra 274 gerçek sesli turun telemetrisine baktık: cevap hattının ilk konuşulabilir metni p50'de 1.844 ms ile belgedekiyle uyuştu, p95'te ise 2,2 değil 4,3 saniye çıktı. Uzun kuyruk küçük örnekte görünmüyordu. O günden sonra gecikme hedeflerini yalnız gerçek trafik telemetrisiyle doğruluyoruz.
Karşılaştırma için: gerçek telefon çağrılarıyla yapılan bağımsız bir 2026 ölçümünde (Openbenchmarks) büyük ses platformlarının medyan ilk ses süreleri 1.296 ile 1.740 ms arasındaydı. Bilgi tabanından cevap üreten sesli asistanların 1,5-2 saniye bandında çalışması olağan.
Kendi hattınızda nasıl uygularsınız?
- Gecikmeyi en az dört kaleme bölün. Tur sonu, tanıma, cevap hattı, seslendirme. Tek sayı yanlış yeri iyileştirmenize yol açar.
- Misafirin hissettiği sayıyı ayrı tutun. Sağlayıcı metriği ile ses kaydındaki gerçek sessizlik farklı çıkabiliyor; bizde bazı turlarda 0,2-2,5 sn fark gördük.
- Model çağrısı gerektirmeyen turları ayırın. Selamlaşma, teşekkür, çalışma saati gibi cümleler kural tabanlı cevaplanabiliyor.
- Isıtmanın gerçekten çalıştığını ölçün. Hata yutan bir ısıtma kodu hiç olmamasından daha tehlikeli, çünkü var sanılıyor.
- Paralel başlatılan her işe süre sınırı koyun. Aksi hâlde hızlandırma bir bekleme noktasına dönüşür.
- Ortalama yerine dağılıma bakın. Sesli kanalda misafiri kaybettiren şey p95'teki turlardır.
Ölçümün sınırları
Önce ve sonra sütunları farklı örnek boyutlarından geliyor (65 tur ve tek doğrulama araması); p95 düzeltmesini yukarıda ayrıca yazdık. Model hız ölçümleri kendi sunucumuzdan, kendi promptumuzla alındı; başka bir hatta sıralama değişebilir. Bu dönemdeki ölçümler ElevenLabs hattında yapıldı. Sonradan kurduğumuz LiveKit ve Cartesia hattının ölçümleri ayrı bir yazıda.
Sık sorulan sorular
Bu bölümdeki sorular, aynı konuda en sık arananlardan derlendi.
01Sesli yapay zekâ asistanında kabul edilebilir gecikme nedir?
Doğal konuşmada iki konuşmacı arasındaki boşluk 100-300 ms civarındadır. Sesli asistanlarda bağımsız ölçümler büyük platformların medyanını 1,3-1,7 saniye arasında gösteriyor. Bilgi tabanından cevap üreten asistanlarda 1,5-2 saniye yaygın bir bant. Asıl sorun ortalama değil, 4 saniyeyi aşan uzun kuyruktur.
02Gecikmenin kaynağı ağ mıdır?
Bizim ölçümümüzde değildi. Sunucudan model sağlayıcısına gidiş-dönüş 1,7 ms'ydi. Süreyi dolduran kalemler niyet sınıflandırıcısı, embedding çağrısı ve cevap modelinin ilk cümlesiydi. Kendi hattınızda ağı suçlamadan önce adım adım süre günlüğü tutmanızı öneririz.
03Daha hızlı bir model seçmek sorunu çözer mi?
Tek başına çözmez. Ölçtüğümüz hatta en büyük kalem modelin kendisi değil, modelden önce çalışan adımlardı. Ayrıca yeni ve "hızlı" diye tanıtılan bir model, düşünme kapatılamadığı için bizim hattımızda daha oynak çıktı. Model seçimini kendi promptunuzla, dağılıma bakarak yapın.
04Paralel (spekülatif) üretim her zaman kazandırır mı?
Hayır. Önden başlatılan iş sık atılıyorsa boşa hesap yapılır; süre sınırı yoksa bir takılma bütün turu bekletir. Bizde önden yapılan arama ilk hâliyle 45 turun 30'unda atılıyordu ve bir aramada 17 saniye takıldı. Ortak süre bütçesi ve iptal sinyaliyle güvenli hâle geldi.
Mustafa Gürbüz
Dolphy Yöneticisi
Dolphy'nin yöneticisi. Sesli asistan, yazılı sohbet ve bilgi tabanı hattındaki testleri yürütüyor. Yazılardaki sayılar Dolphy'nin kendi test ortamında alınan ölçümlerden geliyor; her yazı ölçümün kapsamını ve sınırını da söylüyor.
İçerik 28 Eylül 2026 tarihinde kontrol edildi
Aynı soruları müşterilere tekrar tekrar yazmayın
Dolphy web sitesi, WhatsApp ve Instagram'da işletmenizin kendi bilgisiyle yanıt verir, talepleri panele düşürür.